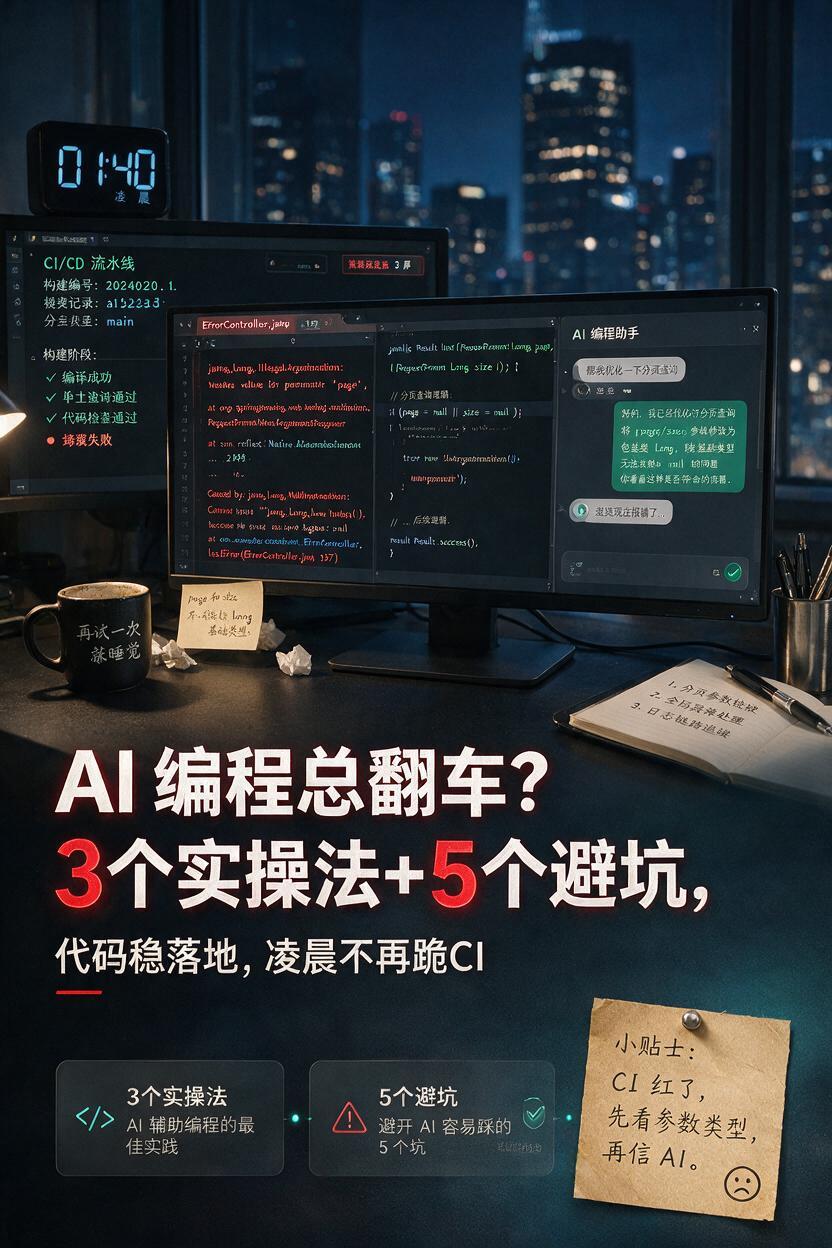
AI编程别把代码库当草稿纸:后端实战避坑
晚上十一点,你让 AI 改一个字段,它删了鉴权中间件
你只是想给订单表加个 channel 字段。提示词写的是:“帮我改一下订单相关代码,把 channel 字段加上。”
AI 很热情,一口气改了 8 个文件:Model、DTO、Mapper、Service、Controller、Swagger 注解、单元测试,还顺手把鉴权中间件“优化”了一版。你编译,报错 27 个;你回滚,发现本地还有没提交的代码;你再看 diff,鉴权逻辑真被删了。
这就是很多后端工程师用 AI 编码工具的日常。
大家对 AI 编程常有两个误区:
误区一:把 AI 当自动补全的升级版。
以为提示一次就能生成可合并代码。实际它更像一个刚入职、记忆力很短、特别敢编 API 的实习生。
误区二:把 AI 当懂你项目的资深同事。
默认它知道你项目里的封装规范、历史债、部署限制。其实你不喂上下文,它只能靠训练数据猜。
下面不聊虚的,直接拆 3 个能照搬的技巧、5 个高频坑,再用一个完整案例复盘。
一、3 个能直接照搬的实战技巧
1. 先喂“项目地图”,再让它动手
操作步骤:
- 把 README、目录树、关键接口定义、数据库迁移文件、统一返回结构贴给 AI。
- 让它先输出“我理解的架构、分层、命名规范、不能碰的模块”。
- 让它列出 3 个不确定问题,你回答完再改代码。
- 最后限定改动范围:“只允许改
order包,禁止动auth、common。”
案例:一个六人团队做订单导出接口,原先同步查 10 万行数据,接口经常 504。工程师让 AI 直接“优化性能”,AI 上来就建议换 ClickHouse、加 MQ、拆微服务。项目只是单体,部署只有一台 4C8G。后来先喂项目地图,AI 才给出可落地方案:Redis Stream 做异步队列、分批查库、导完通知。
【金句:AI coding 的上限,取决于你给它的上下文质量。】
2. 把改动切成可回滚的小块
操作步骤:
- 动手前
git commit或git stash,保证有干净回滚点。 - 让 AI 一次只改一个目标,输出 diff,不要让它直接覆盖全文件。
- 每改完一块,先跑编译、lint、单测,再提交。
- 跨文件重构必须人工评审,别让 AI 连坐改十几个文件。
案例:修一个 N+1 查询。AI 第一版把循环里的查询提到批量查询,逻辑对了,但顺手把返回字段从 List<OrderVO> 改成 Map。前端直接崩。后来限定“只优化查询,不改返回结构”,问题消失。
【金句:让 AI 改代码前,先想好怎么回滚;不能回滚的改动,别让它碰。】
3. 让 AI 先写验证脚本,再写业务代码
操作步骤:
- 提示词里加一句:“先写失败测试、curl 脚本或 SQL 校验,证明当前行为有问题。”
- 等测试跑红,再让它实现业务代码。
- 要求覆盖空值、超时、重复请求、并发边界。
- 测试通过后,再人工看一遍断言是否真有意义。
案例:优惠券并发核销。AI 直接写核销逻辑,看着没问题。让它先写验证脚本后,发现同一个用户并发请求两次,库存判断会穿透。后来补了 Redis 原子扣减和幂等键,才敢上线。
【金句:AI 写业务代码之前,先让它写“怎么证明它没写错”。】
二、5 个高频坑,踩一次疼一次
坑 1:编造 API 和配置项
现象:AI 调用不存在的库方法,比如 redisTemplate.opsForStream().autoAck(),或者编一个 spring.redis.stream.ack-mode 配置。
危害:本地编译过,线上启动报错。
规避:锁依赖版本,把相关依赖源码或官方文档片段贴给它;让它列出“不确定的 API”,你逐个查。
坑 2:一上来就大重构
现象:你只是想加日志,它把 Service 拆成接口+实现+工厂+策略。
危害:改坏原有工程,review 成本爆炸。
规避:提示词明确“禁止跨模块重构”“只允许新增文件,不修改核心类”,先让它出计划,你批准再写。
坑 3:忽略类型、空值和边界
现象:AI 写的代码默认参数一定存在、远程调用一定成功、列表一定非空。
危害:生产环境 NPE、超时拖垮线程池。
规避:要求它显式处理空值、异常、超时、重试、降级;编译开 lint,别用大面积类型断言。
坑 4:长对话上下文污染
现象:同一个会话里聊了订单、用户、支付、部署,AI 把三小时前的需求又塞回来。
危害:改出四不像代码,旧逻辑被覆盖。
规避:新任务新会话,只贴最小必要上下文;重要约束写成清单,别靠它记。
坑 5:把生产密钥粘进提示词
现象:为了调试,把数据库密码、AK/SK、真实用户数据粘进对话。
危害:数据泄露,合规风险。
规避:脱敏、本地 mock、示例数据代替真实数据;公司内用私有部署或企业版工具。
【金句:AI 幻觉不可怕,可怕的是你没检查就合并。】
三、完整案例复盘:订单导出从同步改异步
背景:一个后端接手的订单导出接口,同步查 10 万行,拼接 Excel,接口 P95 超过 3 秒,高峰期 504。项目已有 Redis,没有 MQ,部署单体。
输入提示词:
项目背景:Spring Boot 单体,MySQL,Redis,无 MQ。
目标:订单导出从同步改异步,用户提交后返回任务 ID,完成后可下载。