远赴日韩从事开发长期熬夜损伤身心
我在东京品川那栋写字楼的 11 层数过灯。凌晨两点半,还有七盏亮着,我占其中一盏。
那是给一家日本零售企业做订单中台的第三个月。需求文档每周改一次,改完当天就要在测试环境看到结果。白天开会、对齐、翻译需求,真正写代码的时间被挤到晚上十点以后。咖啡从便利店罐装换成自动贩卖机的热美式,胃药从一天一粒加到三粒。
后来项目转到首尔,节奏没变。凌晨的 KakaoTalk 工作群还在响,客户 PM 发来一句「조금만 더 수정 부탁드립니다」,翻译过来是「麻烦再稍微改一下」。你盯着屏幕上那个已经改到第五版的接口,一句话都说不出来。
身体是先垮的。先是颈椎,再是睡眠,最后是情绪——看到 IDE 的加载动画就犯恶心。
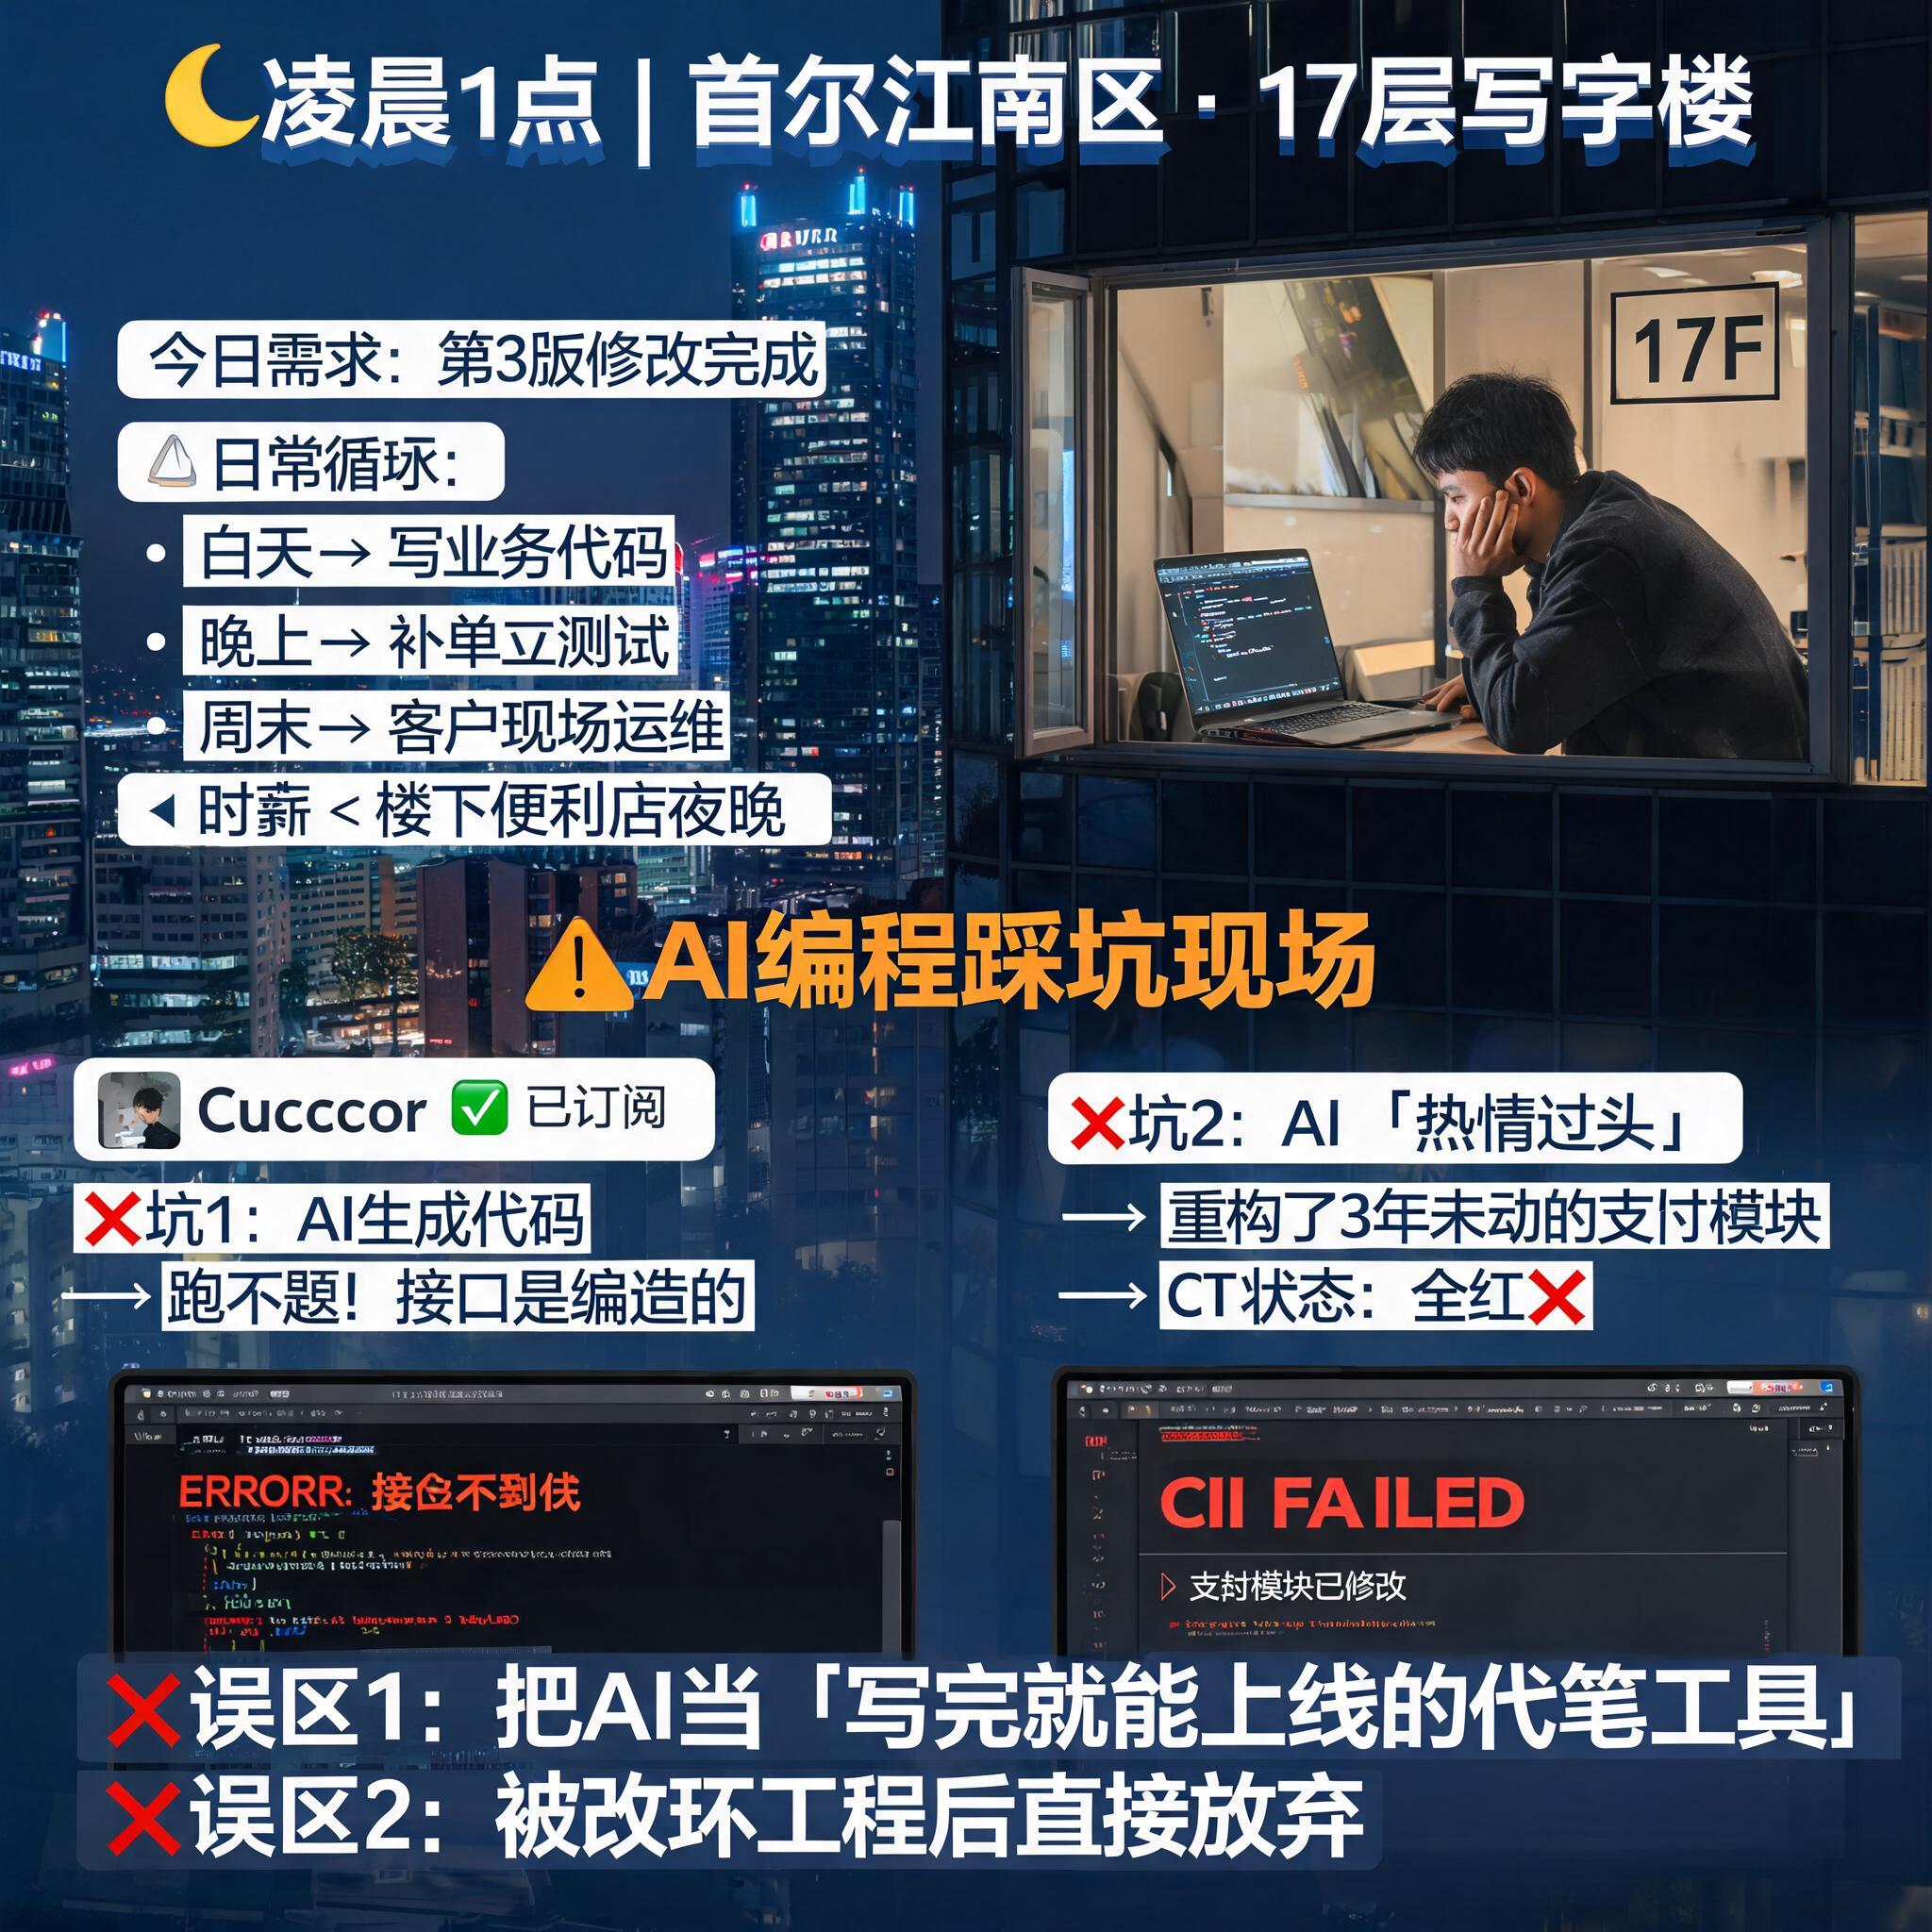
这两年开始认真用 Cursor 这类工具,动机特别朴素:我不想再用命去换一个「再改一版」。但用下来我的结论是,绝大多数人卡在两个误区上。
误区一,把 AI 当打字员。 提示词甩一句「帮我写个订单查询接口」,生成出来不能用,就骂工具不行。
误区二,把 AI 当自动驾驶。 生成什么就提交什么,等发现它顺手删掉你原来的鉴权逻辑,已经在预发环境炸了。
根子是同一个:你没把它当成一个需要交代背景、需要验收、需要划清责任边界的新同事,而是当成了许愿池。
下面几条,都是我在真实项目里反复用过、并且活下来的做法。
一、三个可以直接照搬的实战技巧
1.1 先喂上下文,再提需求
AI 写错代码,八成不是它笨,是你没告诉它你项目的形状。
操作步骤:
- 打开 Cursor,先别急着提需求。用
@把相关文件逐个加进上下文:Controller、Service、对应的 Mapper、实体类、还有三张关键表的建表语句。 - 在项目根目录放一个规则文件,把技术栈版本、命名规范、禁止事项写死。比如「MyBatis 不要用注解写复杂 SQL」「禁止新增第三方依赖」「DTO 不允许直接暴露实体」。
- 上下文喂完,再提需求。需求里必须带三样东西:输入是什么、输出是什么、异常怎么处理。
我在一个对账模块上踩过这个坑。当时直接让 AI 写「订单与支付流水的对账逻辑」,它给我生成了一套基于内存 List 的双层循环比对,五千条数据还行,客户那边实际是日均八十万条。后来我把表结构、索引情况、数据量级一起贴进去,重新提需求,它改成了按日期分片 + 哈希比对,跑完二十分钟。
贴上下文这件事,花你三分钟,能省你三小时。
【金句:AI 不会读心,它只会读你贴给它的那几百行上下文。】
1.2 一次只改一个文件,一次只做一件事
AI 改代码最大的破坏力,来自它「顺便」动了你没让它动的地方。
操作步骤:
- 开工前先
git commit,把当前状态钉死。这是你的后悔药。 - 提需求时明确写:只修改
XxxService.java这一个文件,其他文件不要动。 - 生成后不要点「Accept All」,用 diff 逐行看。Cursor 的 diff 视图会把新增、删除标出来,重点看删除行。
- 确认没问题再提交,提交信息写清楚改了什么。
有个真实场景:我让 AI 给一个老项目的支付回调加一层幂等校验。它改是改对了,但同时把原来的日志格式全换成了它自己的风格,还顺手把一段 try-catch 的异常吞掉逻辑给「优化」了。那次如果不是 diff 看得细,上线后排查线上问题会直接瞎掉。
每一条被删掉的行,都得你能说出它为什么该被删。
【金句:AI 生成的代码不是成品,是待审的 PR。】
1.3 让它先写复现脚本,再动业务代码
这是我从后端调试习惯里挪过来的。改 bug 最怕的是改完不知道有没有真修好。
操作步骤:
- 把报错信息、堆栈、复现路径完整贴给 AI。
- 先要求它写一个能稳定复现问题的最小测试用例或者一段调用脚本。
- 你手动跑一遍,确认这个脚本真的复现了问题。
- 再让它改业务代码,改完用同一个脚本验证。
在一个日韩客户的汇率换算模块上,这个流程救过我。问题表现是「偶尔算出来差一分钱」。AI 第一版给的复现脚本用的是整数金额,跑不出问题。我把它打回去,要求按实际业务里的浮点精度和四舍五入策略来构造数据,第三版才复现出来——原来是 BigDecimal 的 setScale 用错了舍入模式。
没有复现脚本的修复,等于没修。
【金句:先让 bug 稳定地出现,再让它稳定地消失。】
二、五个最容易踩的坑
坑一:幻觉 API。
现象是它调用了一个不存在的库方法,或者某个框架里根本没有的注解。危害是编译不通过,更糟的是有些语言里它不报错但行为不对。规避方式很简单:生成后先编译一遍,再让它自己检查「你刚才用的这几个 API,在我的依赖版本里存在吗」。
坑二:悄悄改动无关逻辑。
现象是你只想加个字段校验,结果它把整个方法的异常处理都重写了。危害是引入了你根本没评审过的变更。规避方式是逐行看 diff,特别是删除行。
坑三:跨文件的上下文缺失。
现象是它调用的那个方法签名,跟你项目里实际的对不上——参数少一个、返回类型不一样。危害是编译报错或者运行时 NPE。规避方式是涉及跨文件调用时,把被调用方的文件也 @ 进去。
坑四:依赖版本乱升。
现象是它为了让代码跑通,建议你升级某个库,或者引入一个新的包。危害是可能牵动一大片兼容性问题。规避方式是把「禁止新增依赖」写进规则文件,真有需要,单独开一个 PR 处理。
坑五:需求含糊导致它替你做决定。
现象是你写「优化一下这个查询」,它给你加了缓存、改了索引、还顺手拆了方法。危害是改动范围远超预期。规避方式是需求里写清楚边界:「只做 SQL 层面的优化,不改方法签名,不加缓存」。
三、一个完整项目的复盘
项目背景:给一家韩国客户做会员积分系统的接口层重构。老代码是五年前写的,一个 Service 类三千多行,接口文档和实现早就对不上了。
第一步,摸底。 我把整个 Service 类、相关的 DTO、以及数据库表结构全部加进上下文,然后问它:「这个类里有哪些方法,各自做了什么,有没有重复逻辑」。它输出了一份清单,标出了七个功能重复的方法。这份清单我自己核对了两个小时,基本准确。
第二步,定边界。 我给它的提示词是这样的:
现在要重构
PointService。约束条件:一、对外接口签名不变;二、逐个方法重构,每次只处理一个方法;三、每个方法重构后,必须给出对应的 JUnit 测试;四、不许改动PointMapper和实体类。
第三步,逐个推进。 重构到第四个方法时出了问题。它把一段按会员等级计算积分的逻辑,从 if-else 改成了策略模式,代码是漂亮了,但漏掉了一个等级为 null 时走默认值的分支。测试没覆盖到这条路径。
第四步,补漏。 我把原有的所有分支条件列出来,让它逐个对照,补齐测试用例。补完之后再跑一遍,通过。
结果: 三千行的类拆成了六个类,核心方法的圈复杂度从二十多降到六。整个过程花了两天,如果纯手写,我估计要一周,而且中间免不了熬夜。
代价: 它生成的测试用例覆盖率大概只有七成,边界条件还得我自己补。以及,中间我打回了四次生成结果。
四、总结与行动清单
工具是工具。Cursor 在「读懂现有代码结构、批量生成样板代码、写测试骨架」这几件事上确实省时间,但它在「理解你项目的隐性规则」和「判断业务边界」上依然会犯错。你省下的时间,一部分要还给它犯的错。
三件你现在就可以动手的事:
- 今天就在项目根目录建一个规则文件,写清楚技术栈版本、命名规范、三条禁止事项。下次用 AI 之前先让它读一遍。
- 下次改 bug,先让它写复现脚本,脚本跑不出问题就不许它动业务代码。
- 挑一个你项目里最长的那个方法,加进上下文,让它分析有哪些重复逻辑,你自己核对一遍清单。这一步不写代码,只练「怎么给它交代背景」。