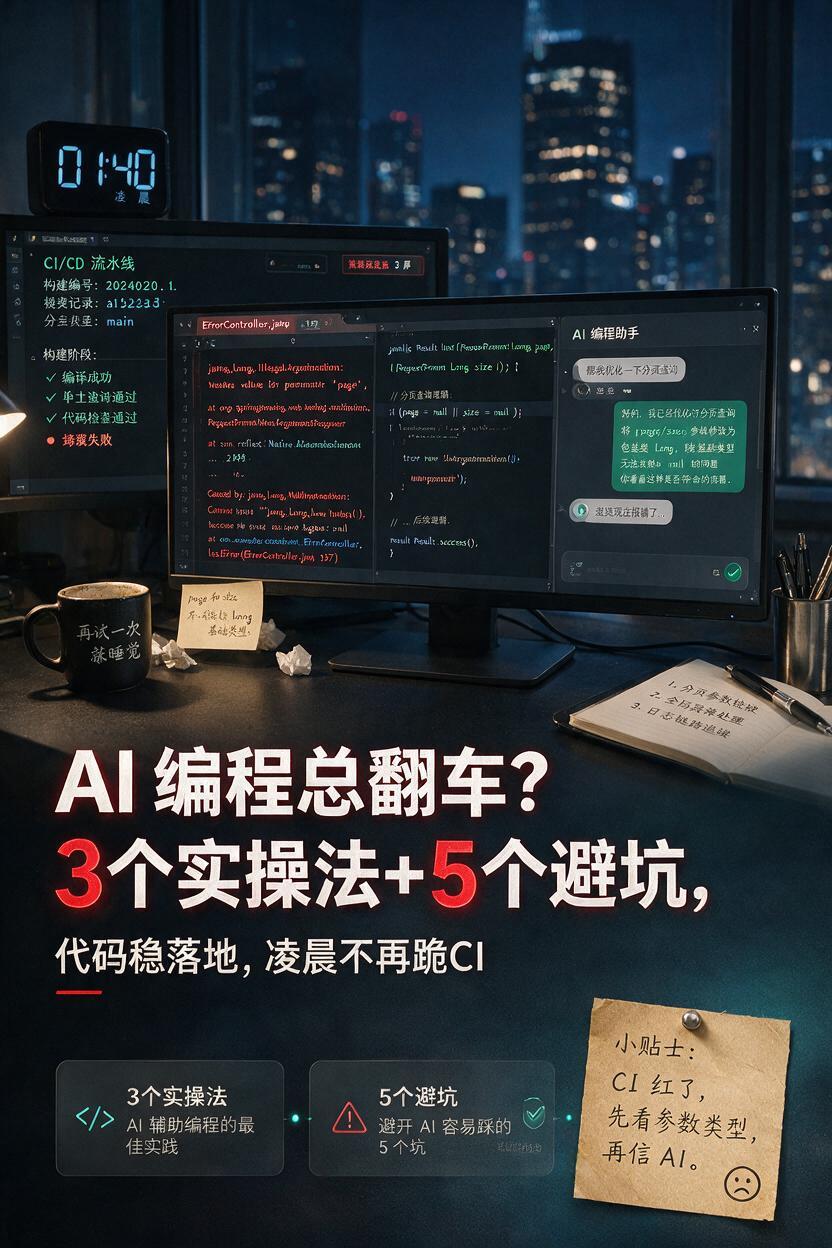
周四晚上十一点四十,你盯着屏幕上一段刚被 Cursor 改过的支付回调代码。你只是想让它加个幂等判断,结果它顺手把整个 OrderService 重构了一遍,引了三个你项目里根本不存在的包,Apply All 点下去,本地跑起来直接 500,数据库里还多了三条重复流水。
这种夜晚,用 AI 写代码的人都经历过。
现在用 Cursor 的开发者分两类。一类把它当更聪明的搜索框,问一句"帮我优化下这段代码",然后对着一段风格陌生的输出发呆;另一类把它当自动写码机,生成即完成,跑通即上线。这两类人踩的是同一个坑——把 AI 当成了一个随叫随到的陌生人,而不是一个刚入职、能力很强但完全不懂你项目的同事。
下面这些东西,是我和团队在实际项目里一次次翻车、再一次次拧回来的做法。不讲原理,只讲能直接照搬的操作。
一、三个照搬就能用的实战技巧
1.1 先给项目立规矩,再让 AI 动笔
别急着让 Cursor 写第一行业务代码。先在项目根目录建 .cursorrules 或者 .cursor/rules 目录,把你项目里那些"没人写在文档里但人人都知道"的规矩写进去。
我一般会写这几类:
- 技术栈版本,比如 Go 1.22、用
chi不用gin、ORM 用sqlc不用 GORM - 错误处理约定,比如统一用
errors.Is判断,禁止err.Error() == "xxx"这种字符串比较 - 日志规范,比如用
slog,字段名固定为trace_id、user_id - 明确禁止的事情,比如不许引入新依赖、不许改 database 层、不许动
go.mod
为什么这一条最值钱? 因为 AI 幻觉里最烦的不是语法错,是它自作主张地"帮"你换技术方案。你把边界写清楚,它出错的空间就少一大半。
我待过的一个 Go 后端项目,团队统一用 sentinel error 做业务判断。没写规则文件之前,AI 生成十个错误处理有六个是字符串比对的土办法,review 的时候得一个个改。把规则写进去之后,这类低级返工基本清零。
注意:规则文件别写成几百行的百科。控制在 30 到 50 行,只写"和默认行为不一样"的部分。写太多,模型反而抓不住重点。
【金句:AI 写的代码像不像你团队的代码,取决于你有没有把团队的规矩告诉它。】
1.2 把任务切到"一次能 Review 完"的粒度
这是我最想让你养成的一个习惯:永远不要让 AI 一次性改超过一个函数、一个接口、一个文件的量级。
反例长这样:你把整个 RefundService 三千行丢进去,说"帮我加一下退款幂等"。它会给你生成一大坨 diff,你翻到第三屏就懒得看了,直接 Apply,然后出问题。
正例是这么做的:
- 先在对话里说清楚"只改
HandleRefundCallback这一个函数" - 让它先列出改动清单,你确认
- 改完,跑测试,
git commit一次 - 再进下一个函数
这样做的代价是你多敲了几次回车,收益是每次改动都能被你看懂、能被 git diff 卡住、出问题能一秒回滚。用 AI 写代码,真正的效率不是在生成速度上省出来的,是在回滚和排错上省出来的。
我自己在小团队里推这套做法的经验是:一个人一天下来的提交次数会变多,但一个功能真正跑通的时间反而短了一截——因为几乎没有哪次是"改崩了再排查半天"。
前提条件:你得有测试。没有测试的项目,把粒度切小也白搭,因为你不知道改完到底有没有坏。
【金句:AI 最爱在你看不完的 diff 里藏 bug,你要做的就是把 diff 缩短到看得完。】
1.3 先让它出方案,再让它动代码
很多人跳过方案,直接说"帮我实现订单超时自动关闭"。这就是幻觉高发的起点。
我现在的固定套路是三段式:
第一轮,让它只输出方案,不写代码。提示词大致是:
先别写代码。请告诉我:
- 你打算改哪些文件、哪些函数
- 每个改动的影响面是什么(谁调用它、有没有并发问题)
- 需要补哪些测试用例
- 有哪些你没把握、需要我确认的点
第二轮,你逐条看,把不对的地方当场纠正。它列出的"没把握的点"往往就是项目里最坑的地方,比如定时任务和手动关闭的竞态。
第三轮,确认完再让它落代码,一次改一个点。
多花五分钟对话,省掉五十分钟 debug。而且这个流程还有个副作用:它会主动暴露自己不确定的地方,你能提前发现幻觉,而不是等它生成完才发现。
【金句:让 AI 先交方案再交代码,它的幻觉会提前暴露在对话里,而不是埋进你的仓库里。】
二、五个最容易踩的坑
坑一:相信它编出来的 API。
现象:它调用一个方法,签名看着合理,实际 SDK 里根本没有,或者早就废弃了。
危害:编译不过还是小事,最怕它用了一个语义相近但行为不同的旧接口,编译通过、线上跑偏。
规避:凡是涉及第三方库的调用,让它顺手附上文档链接或版本号;动手前用 IDE 的跳转确认方法真实存在。陌生依赖,先跑一个最小的 demo 验证。
坑二:一口气让它重构整块业务。
现象:你说"帮我重构这个模块",它把命名、结构、异常处理全改了一遍。
危害:代码 review 无从下手,出问题时分不清是原逻辑就有的 bug 还是它改出来的。
规避:重构必须拆成明确的小目标,一次只重构一个职责。重构和加功能不要混在同一次对话里。
坑三:上下文塞得太满。
现象:你把十个文件贴进对话,AI 反而开始答非所问,甚至把不同文件的字段张冠李戴。
危害:生成的代码逻辑混乱,你越追问它越偏。
规避:一次只让 AI 关注跟当前任务直接相关的两三个文件。需要的背景用文字描述,别一股脑全塞进去。开新任务就开新对话。
坑四:不跑测试就应用。
现象:看着挺合理,直接 Apply,觉得"AI 写的应该没问题"。
危害:每一次偷懒都在给未来的自己埋雷。
规避:改动后至少跑一遍受影响的单元测试。没有测试的模块,先补一个能覆盖主流程的最小测试再动手。
坑五:对着 AI 描述"你脑子里的需求"。
现象:你心里清楚要什么,但说出来的话含糊,比如"优化一下这个查询性能"。
危害:它按自己的理解改,方向完全不对,来回拉扯还浪费时间。
规避:把需求写成可验证的句子。不是"优化查询",而是"这个接口 P99 超过 800ms,目标是压到 200ms 以内,不能改表结构"。
三、一次完整复盘:给支付回调补上幂等
任务背景:一个订单支付回调接口,支付方会重复推送通知,历史上出过重复入账。我要给它加幂等处理,但代码里牵扯到订单状态机、账户流水、消息队列三个模块,谁都不敢轻易动。
我的第一轮提示词:
先别改代码。读一下
PaymentCallbackHandler这个函数。支付方会重复推送同一笔交易,现在可能重复入账。请列出:
- 你打算在哪里加幂等判断,为什么选这里
- 涉及并发时的风险点
- 需要补的测试用例
- 你不确定、需要我确认的点
它给出的方案:在进入状态机之前,用支付方的 trade_no 做唯一键,先查一张回调记录表;查不到就插入并继续处理,插不进去说明是重复推送,直接返回成功。
中间冒出的问题:它建议直接在 handler 里加分布式锁。我当时判断这个方案引入了新的基础设施依赖,而且锁的超时时间很难定,回滚成本高。我在对话里否掉了,改成"唯一键 + 唯一索引"的数据库层兜底。它随后补充了另一个我没想到的点——同一个 trade_no 在极短时间内并发到达时,会有一个请求拿到唯一键冲突异常,这个异常必须被捕获并当成"已处理"返回,而不是抛给上游。这条提醒帮我省了一次线上事故。
最终落地:回调记录表加唯一索引;handler 拆成"记录 + 处理"两步;主流程补了三条测试——首次回调、重复回调、并发重复回调。
结果:改动只落在一个文件和一张新表上,git diff 不到 150 行,一次 review 就过。上线后支付方压了两轮重复推送,账户流水没有再出现重复入账。
【金句:复杂任务里,AI 最大的价值不是替你写代码,而是提醒你那些你没想到的边界情况。】
四、总结与马上能做的三件事
Cursor 这类工具确实把很多重复劳动吃掉了,但它有两个绕不开的短板。一是它不知道你项目的隐性约束,你不写它就不懂;二是它对"没把握"的地方往往不主动说,而是给你一段看起来很像样的代码。你越依赖它直接产出,越容易在看不见的地方栽跟头。
所以,工具的能力上限,取决于你给它划的边界有多清楚。
今天就能动手的三个练习:
- 给你的主力项目写一份不超过 50 行的
.cursorrules,只写和默认行为不一样的地方,写完后拿一段旧代码让 AI 重写,看风格对不对得上。 - 挑一个你最近想改但不敢改的函数,用"先出方案、再动代码"的三段式流程走一遍,全程不跳过方案确认。
- 找一个没有测试的模块,先用 AI 补一个覆盖主流程的单元测试,再让它动手改任何一行业务代码。
试完这三件事,欢迎回来在评论区说说你踩到的坑。如果这篇对你有用,顺手收藏一份,下次写规则文件的时候能直接翻出来。