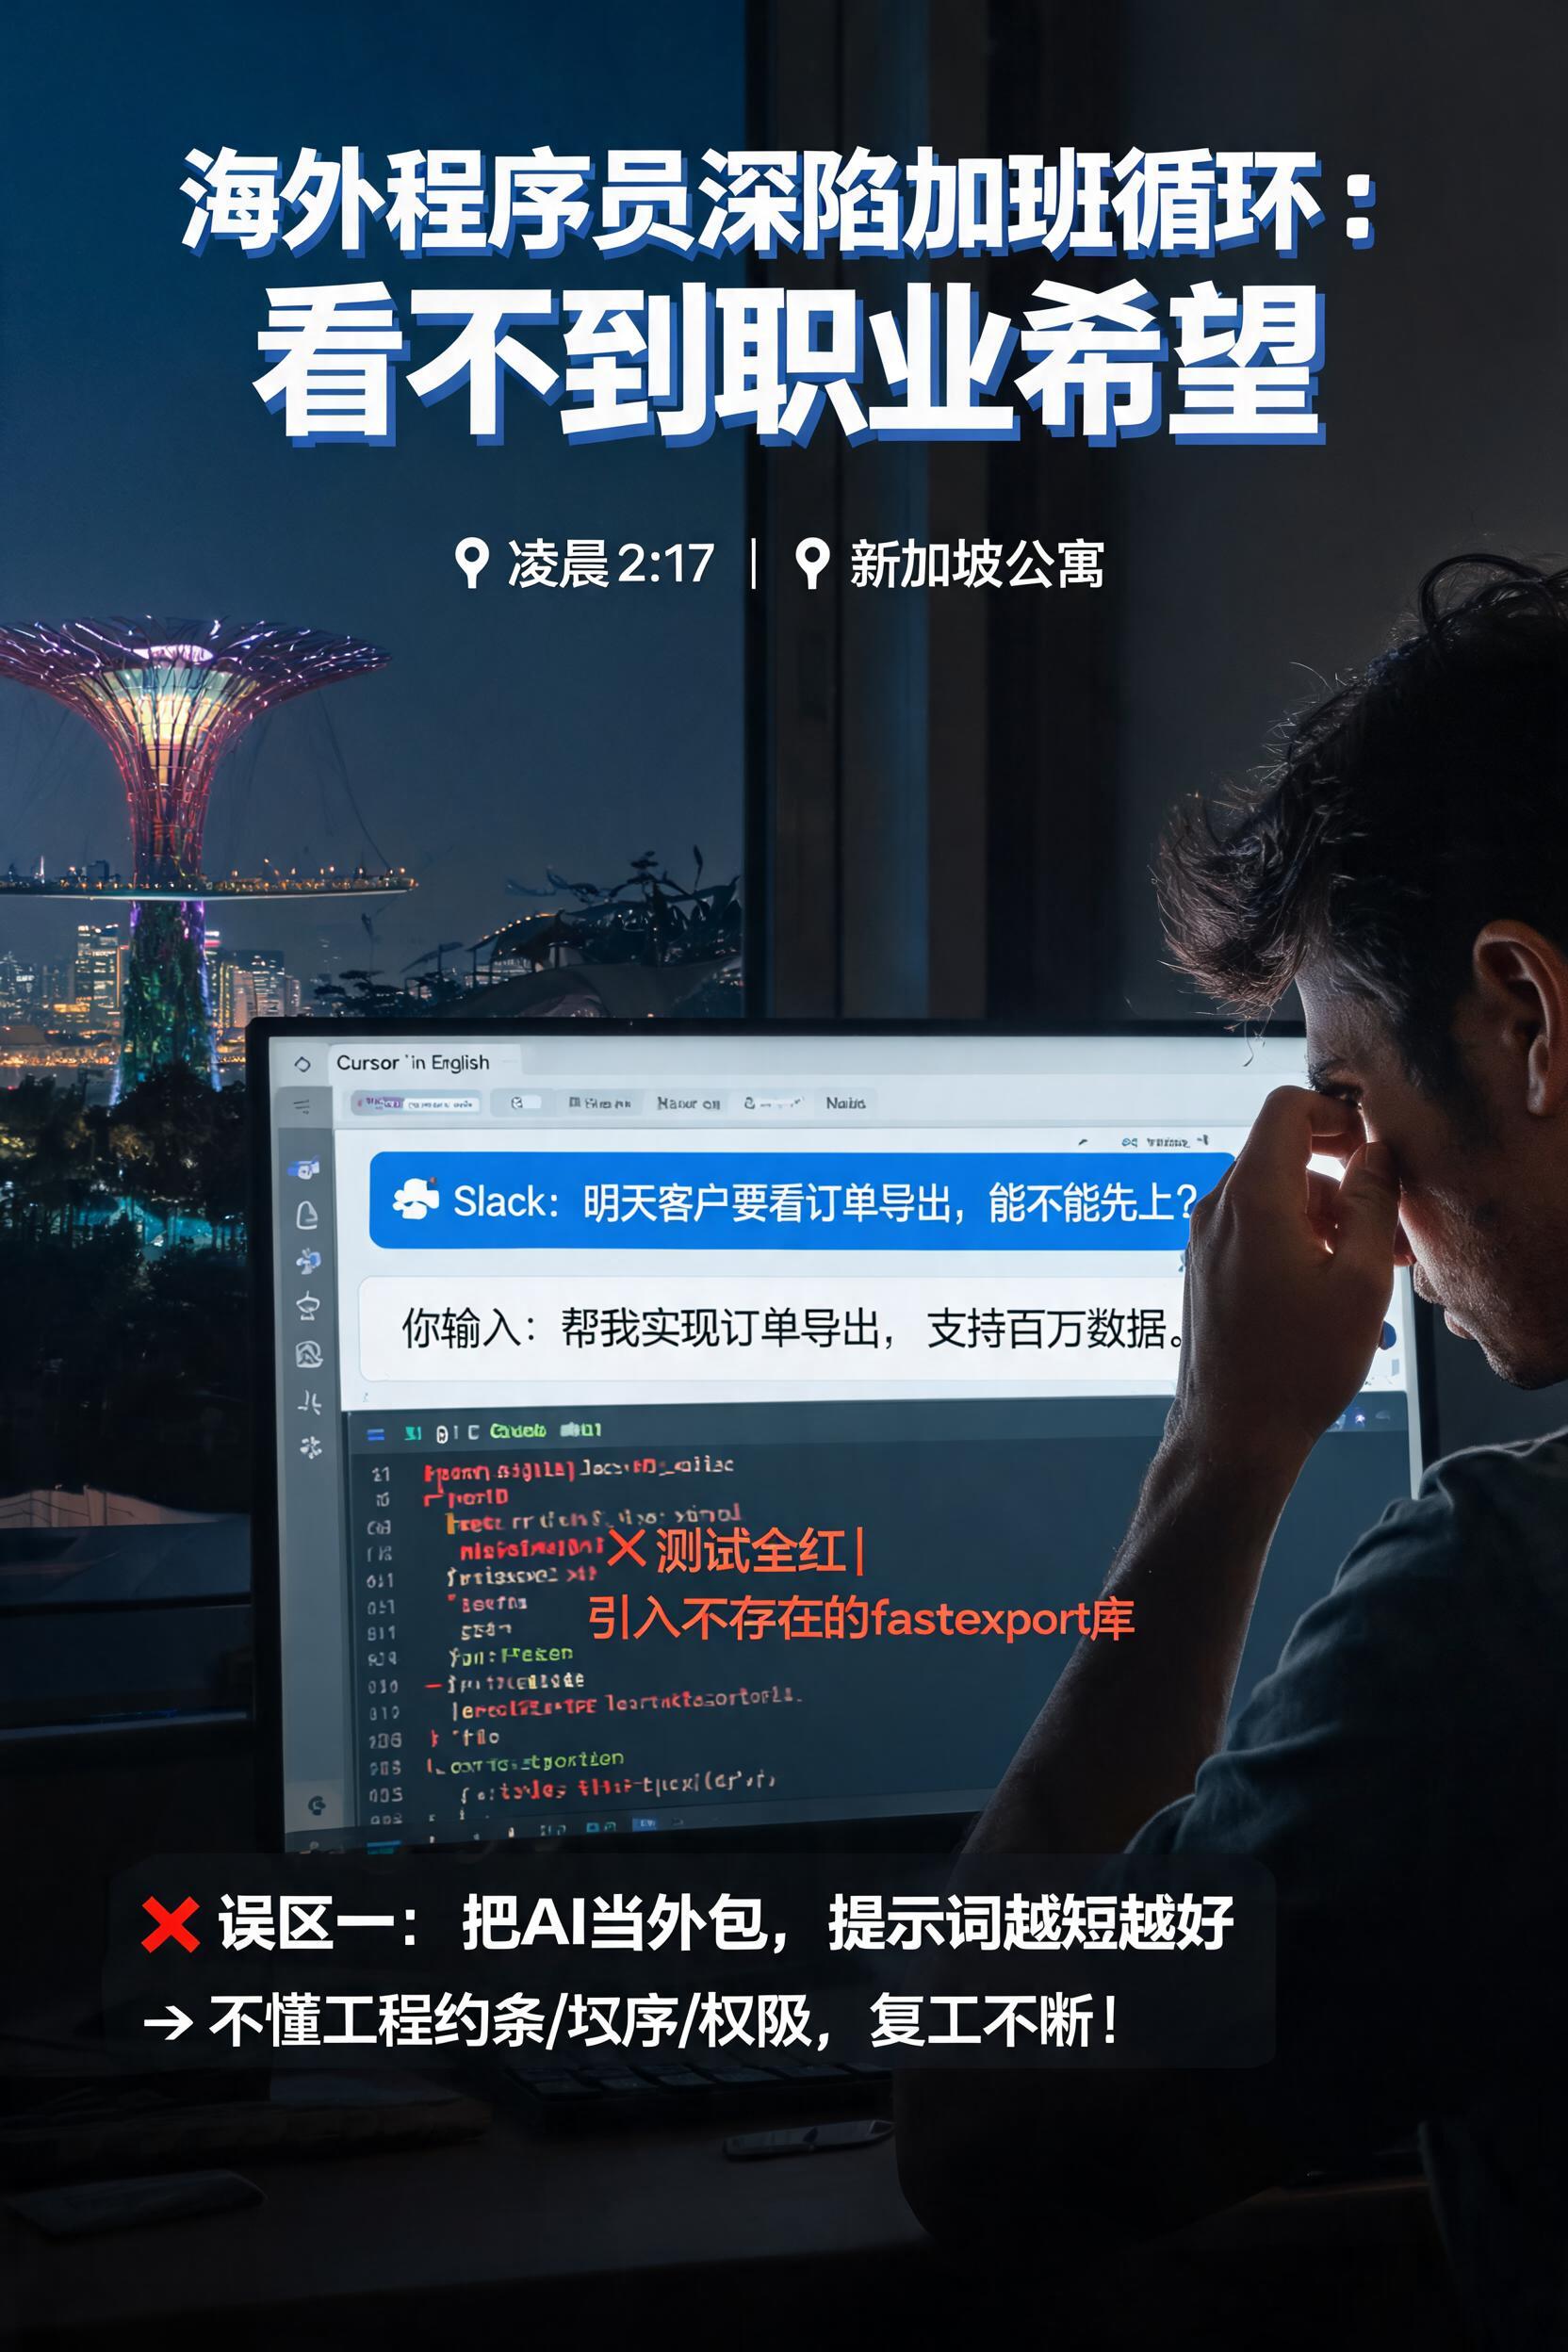
凌晨一点,首尔江南区某栋写字楼的十七层还亮着灯。你刚把今天第三版需求改完,白天写业务代码,晚上补单元测试,周末还要去客户现场做运维支持。折算下来,时薪不如楼下便利店的夜班。这不是段子,是不少日韩 IT 岗位的日常:薪资在发达国家梯队里排不上号,活儿却是实打实的重。
于是很多人把希望押在 AI 编程工具上——Cursor 装了,订阅买了,用两个月,发现事情不太对。要么 AI 生成的代码跑不通、接口是编的,要么它热情过头,顺手把你三年没动过的支付模块重构了一遍,CI 直接红成一片。
这两个误区,几乎每个开发者都会踩一次:一是把 AI 当成「写完就能上线的代笔工具」,二是被它改坏过一次工程后,干脆退回全手写。
先说结论:Cursor 这类工具真正的价值,不是替你写代码,而是替你干那些重复、琐碎、需要反复查文档的脏活。用它的人分两拨,一拨在骂它胡说八道,一拨把交付效率提了一截。差别不在工具版本,在于你有没有把它当同事用,而不是当许愿池。
一、三个能直接照搬的实战方法
1.1 把任务拆到「一个函数能装下」
AI 改坏工程的头号原因,是你给的任务太大。你说「帮我加个订单退款功能」,它可能给你改 8 个文件、新增 3 个类、顺手换掉你的日志库。
操作步骤:
- 把任务切成一次只改一个文件、一个函数的最小单元;
- 提示词里写清三件事:输入输出、边界条件、失败时应该返回什么;
- 在提示词里贴 2-3 个项目里已有的同类函数当范例。
注意: 一次只让 AI 动一个文件。改完确认能编译、能过测试,再开下一个。
真实案例: 某团队要给结算模块加多币种支持,直接说「支持多币种」,AI 把实体类、汇率表、DTO、Mapper 全改了,编译都过不去。后来拆成三步——先只改 Money 值对象加 currency 字段,再只改汇率转换工具类,最后才动业务逻辑。三步走完,改动量反而比一次大改更小,Review 时间从两小时压到二十分钟。
把大任务拆小,不会让 AI 变聪明,但会让它的错误变得便宜。
【金句:不要问 AI「怎么做这个功能」,要问它「照着这个函数的样子,把那个函数改掉」。】
1.2 用规则文件把团队约定钉死
AI 不知道你们团队不用 Lombok、不引新依赖、日志必须走统一封装。你不说,它就按网上最流行的来。
Cursor 的 rules 文件就是干这个的。别写抽象原则,写具体到能执行的条条框框:
- 语言与框架版本,比如「Java 17 + Spring Boot 3.2,不用 Lombok」;
- 包结构约定,比如「Controller 只做参数校验,业务逻辑一律放 Service」;
- 错误处理方式,比如「业务异常统一抛
BizException,不返回 null」; - 明确禁止的事,比如「不新增任何 Maven 依赖,需要新库先问我」。
真实案例: 一个团队接了个遗留系统改造,代码风格混乱。他们把规则文件写好后,AI 生成的代码首次通过 Review 的比例从不到四成提到了七成多,省下的全是来回扯皮的时间。
坑点提醒: 规则文件不是越长越好。超过两屏,AI 就开始选择性遗忘。只留那些「违反了会出事故」的红线。
【金句:规则文件的作用不是让 AI 懂你,是让它别自作主张。】
1.3 先让 AI 复述,再让它动手
最省时间的习惯,是在生成代码前多问一句:「先别写代码,告诉我你打算改哪几个文件、每个文件改什么、有没有风险。」
它列出来的计划,就是最便宜的 Review。计划错了,你花十秒纠正;代码错了,你可能花两小时 debug。
配合 git 用效果更好:每次让它改之前先 commit 一次,改完 git diff 逐块看。看到不认识的改动,直接问它「第 47 行为什么这么改,原来的写法有什么问题」。很多时候它会老实承认「这里我想多了」。
二、五个最容易踩的坑
坑一:接口和依赖是编的。
现象:AI 调用了一个不存在的 SDK 方法,或者引用了一个没装过的库。
危害:本地跑不通,浪费半小时查文档,最后发现这方法压根没有。
规避:凡是涉及第三方库的调用,让它把版本号和官方文档链接一并给出;拿不准就自己先查一遍 API。
坑二:顺手「优化」你的老代码。
现象:你只让它加一个字段,它把整个类重写了,命名风格、异常处理全变。
危害:git diff 一片红,Review 无从下手,线上风险陡增。
规避:提示词里明确写「只做必要改动,不要重构无关代码」,并用 git diff 检查。
坑三:对话开太长,上下文被污染。
现象:聊了三十轮之后,AI 开始忘记前面定好的规则,又开始胡写。
危害:越到后面越不靠谱,你却以为它变笨了。
规避:一个任务一个新会话,把关键约束重新贴一遍。长任务记得中途总结一次现状再继续。
坑四:直接信它写的 SQL 和并发代码。
现象:AI 给的 SQL 少了 WHERE 条件,或者加锁顺序反了。
危害:这不是 bug,是事故。
规避:涉及数据修改、事务、锁、幂等的代码,一律人工逐行过。AI 在这类问题上最大的特点是:错得非常自信。
坑五:只测「它说没问题」的路径。
现象:AI 跑通了 happy path,边界条件全漏。
危害:测试全绿,线上照崩。
规避:让 AI 反过来列「这段代码在什么输入下会出错」,然后逐个补测试用例。
【金句:AI 写代码快,但它的错误也快。你省下的打字时间,得拿 Review 时间补回来——区别是 Review 比打字便宜得多。】
三、一次完整复盘:给订单服务加幂等
背景: 支付回调会被重复推送,同一笔订单可能被处理两次,导致重复发货。这是典型的分布式问题,也是 AI 最容易给出「看起来对」的方案。
我给的提示词:
我们的订单服务在收到支付回调时会更新订单状态并触发发货。现在同一个回调可能被推送多次,导致重复发货。请先不要写代码,先告诉我:
- 你建议用哪种幂等方案,为什么;
- 需要改哪几个文件;
- 这个方案在什么情况下会失效。
技术栈:Java 17 + Spring Boot 3.2 + MySQL 8 + Redis,已引入 Redisson。
它第一版给的方案: 用 Redis 做分布式锁,锁 key 是订单号。
中间发现的问题: 锁只能防并发,防不了重复推送。第一次回调处理完释放锁,第二次回调进来照样能拿到锁,还是重复发货。
我追问:「如果两次回调间隔 10 秒,锁已经释放了,这个方案还成立吗?」它自己也承认不成立,改成了「幂等表 + 唯一索引」的方案:建一张 payment_callback_log 表,callback_id 加唯一索引,插入成功才继续处理,插入冲突直接返回。
最终成果: 改动集中在三个文件——新增一张表和对应实体、加一个幂等校验 Service、在回调入口插一行判断。改动量小到可以当天上线,Review 花了不到半小时。
这次经历最大的收获不是那个方案,而是「先让它讲思路、再由我挑毛病」这个流程。 如果一开始就让它写代码,我大概率会拿到一个带分布式锁的方案,测试环境跑得通,线上重复发货。
总结:三条今晚就能动手的练习
明确一点:Cursor 不是银弹。它对冷门框架、内部 SDK、复杂的分布式一致性问题的理解,依然会出错,而且错得理直气壮。上下文一长,它就失忆;任务一大,它就放飞。它的定位应该是一个打字很快、记性一般、需要你盯着的初级同事。
三条练习,今晚就能试:
- 给你的项目写一份 20 行以内的规则文件,只写红线,写完观察一周,看 AI 生成代码的首次通过率有没有变化。
- 挑一个你最熟的业务函数,让 AI 照着它写一个相似的,对比一下差异在哪,你就知道该给它补什么上下文。
- 找一个你以前调了两小时以上的 bug,重新用「先讲思路再写码」的流程走一遍,记录你实际花了多久。
觉得有用,可以收藏转发给组里正在被重复回调折磨的同事。也欢迎在评论区聊聊:你用 AI 工具最惨的一次翻车是什么?