你代码写得越快,天花板来得越早
上个月,一位做了四年 Java 后端的朋友找我喝酒。他刚拒掉一个涨薪 15% 的 offer,理由是“去了也是干一样的活,工资涨了,天花板还在那儿杵着”。
他每天用 Cursor 写接口、生成单测、修补丁,效率比两年前翻了一倍。但他发现一个尴尬的事实:他提交代码的速度越快,公司给他的定位就越像一个“需求翻译器”——把产品文档翻译成 CRUD,再把 CRUD 翻译成可运行的 Spring Boot 工程。
这不是他一个人的困境。从去年 Copilot 普及到今年 Cursor、Claude Code 大面积进入日常开发,基层开发岗正在经历一轮悄无声息的挤压:入行即触碰薪资天花板。
为什么?因为大多数人对 AI 编程工具有两个致命误区:
误区一:把 AI 当“更快的手”,而不是“更强的脑”。 你用它补全代码、生成样板,结果只是把月薪 15k 的活干成了月薪 10k 的速度,老板不会因此给你 25k。
误区二:以为“会用工具”就是竞争力。 会用 Cursor 不稀缺,能判断 AI 生成的代码在复杂工程里能不能落地、会不会改坏原有逻辑,才稀缺。
这篇文章不聊虚的。下面直接拆 Cursor 的实战技巧、高频坑点,以及一个真实项目复盘。目标只有一个:帮你把 AI 编程从“提效工具”变成“突破天花板的杠杆”。
【金句:写代码快不是壁垒,知道什么代码不该让 AI 写才是。】
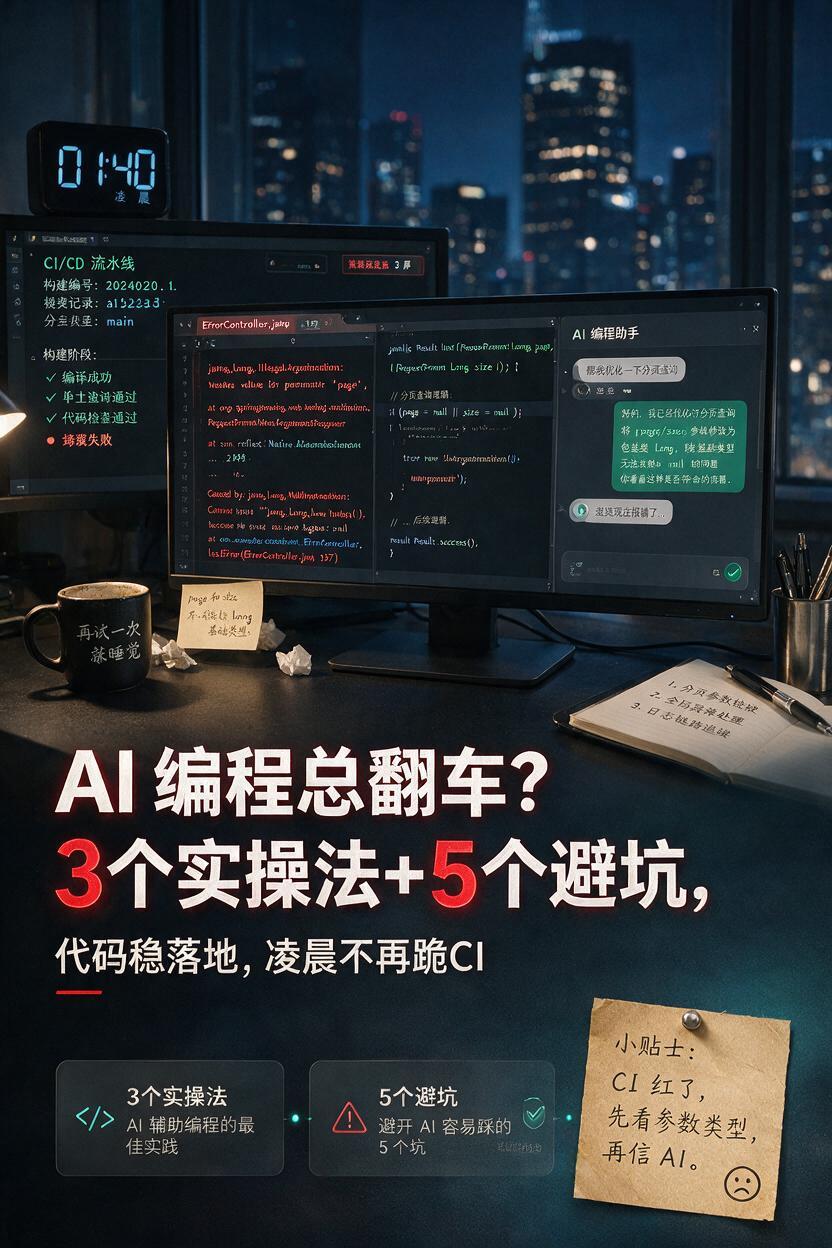
一、三个可照搬的 Cursor 实战技巧
1.1 用 .cursorrules 给项目装上“护栏”,别让 AI 猜
操作步骤:
在项目根目录建 .cursorrules 文件,写清楚:技术栈版本、目录结构约定、禁止事项、代码风格。比如:
- 框架:Spring Boot 3.2 + Java 17
- 禁止使用 field injection,必须用构造器注入
- Controller 层不允许写业务逻辑,全部放 Service
- 数据库操作统一走 MyBatis-Plus,禁止在 Service 里拼 SQL
真实案例: 我接手过一个老项目,所有接口都写在 Controller 里,一个类 2000 行。用 Cursor 重构时,没写 .cursorrules 之前,它把新代码又塞回 Controller 了。加上规则后,它自动把业务逻辑抽到 Service,Controller 只留参数校验和路由。
注意:
.cursorrules不是一劳永逸的,每次项目架构调整都要同步更新。AI 不会读心术,你写多细,它做多好。
1.2 分步指令:把“帮我写个模块”拆成“先看再写”
操作步骤:
不要一上来就让 Cursor 写完整功能。按这个顺序:
@Codebase让它先读懂相关文件,输出它理解的调用链路- 让它给出实现方案,你确认后再让它写
- 写完后让它自己 review 一遍,指出可能的风险
真实案例: 做一个订单导出功能,直接说“写个 Excel 导出”它会给你一个 POI 的 HSSFWorkbook 硬编码。先让它读现有的 ExportService,它发现项目已经封装了 EasyExcel,于是直接复用,少引入一个依赖。
1.3 用“反向提问”逼 AI 暴露假设
操作步骤:
AI 写完代码后,追加一句:“你刚才的实现里,有哪些假设条件?如果这些条件不成立,哪里会崩?”
真实案例: Cursor 帮我写了一个缓存更新逻辑,我追问后它承认:“假设了 Redis 永远可用,没有降级。” 就这一句话,避免了一次线上缓存雪崩。
【金句:AI 不会告诉你它不知道什么,你得学会问它“你不知道什么”。】
二、五个高频坑,每一个都有人栽过
2.1 幻觉 API:它编的函数根本不存在
现象: 调用了一个 userService.batchUpdateWithAudit(),编译报错——项目里压根没这个方法。
危害: 浪费半小时排查,新手甚至怀疑自己记错了。
规避: 让 Cursor 引用具体文件路径,开启 @Codebase 索引。如果它写的方法你没见过,先全局搜索确认存在。
2.2 大范围重构:一改改崩整个模块
现象: 让它“优化这个类的设计”,它把方法签名全改了,直接编译不过。
危害: 原有工程被改坏,回滚都费劲。
规避: 永远在 Git 干净的分支上操作,重构前先 commit。让 AI 一次只改一个方法,别贪。
2.3 上下文截断:它忘了你前面说的约束
现象: 前面说了“用 Java 17 的 record”,写到第三个类又用回了 Lombok。
危害: 代码风格分裂,review 时被同事骂。
规避: 长对话中定期重申关键约束,或者把约束写进 .cursorrules。
2.4 过度信任 AI 写的测试
现象: AI 生成的单测全绿,但测的是它自己编的 mock 逻辑,实际业务路径没覆盖。
危害: 虚假安全感,上线后 bug 照出。
规避: 单测必须自己审查断言逻辑,特别是 mock 的返回值是否合理。
2.5 忽略版本差异
现象: 你项目是 Spring Boot 2.7,它给你生成 3.x 的配置写法。
危害: 启动直接报错。
规避: 在提示词里明确版本号,比如“基于 Spring Boot 2.7 + JDK 8”。
【金句:AI 写代码是概率游戏,你 review 代码是确定性防线。】
三、真实复盘:用 Cursor 给老系统加异步任务队列
背景: 一个运营后台,导出 10 万条订单时接口超时。需要改成异步任务 + 轮询进度。
我的输入提示词:
@Codebase 读一下 OrderExportController 和 OrderExportService。现在导出是同步的,超过 30 秒就超时。帮我改成异步:提交任务返回 taskId,后台线程池执行,前端用 taskId 轮询进度。线程池配置放在 application.yml。不要引入新的 MQ,用 Spring 的 @Async。
中间问题:
- 第一版它用了
Executors.newFixedThreadPool,我指出要用ThreadPoolTaskExecutor配合 yml 配置 - 它没处理任务状态存储,我让它加了
ConcurrentHashMap存进度,并提醒要考虑内存泄漏 - 最后它生成的
@Async方法在同一类内调用,代理不生效——这是经典坑,我让它自己检查,它承认了并改成拆到独立 Bean
最终成果:
导出接口响应从 30 秒+ 降到 200ms 返回 taskId,后台线程池处理 10 万条约 40 秒,前端轮询进度条。上线后没出问题。
关键心得: AI 能写出 70 分的骨架,剩下 30 分是你对 Spring 代理机制、线程池、内存管理的理解。这 30 分,就是你离天花板的距离。
总结:三条马上能做的练习
- 今天给你的项目加一个
.cursorrules,写上三条你最不能忍的代码规范,观察 Cursor 的生成质量变化。 - 找一段 AI 写的代码,用“反向提问”逼它暴露假设,看看你能挖出几个隐藏风险。
- 在干净分支上让 Cursor 重构一个 200 行以内的方法,体验“分步指令”和“一次只改一个方法”的节奏。
最后说句客观的:Cursor 很强,但它不会替你理解业务、不会替你背线上事故的锅、更不会自动帮你突破薪资天花板。它能帮你省下敲键盘的时间,但省下来的时间用来干什么,才是拉开差距的地方。 如果你只用来刷更多的 CRUD,那天花板只会来得更快。
觉得有用,收藏转发给那个还在闷头写代码的朋友。评论区聊聊:你用 AI 编程工具踩过最坑的一次是什么?