赴日韩做开发收入有限却要忍受无尽加班
东京十点四十,首尔凌晨一点
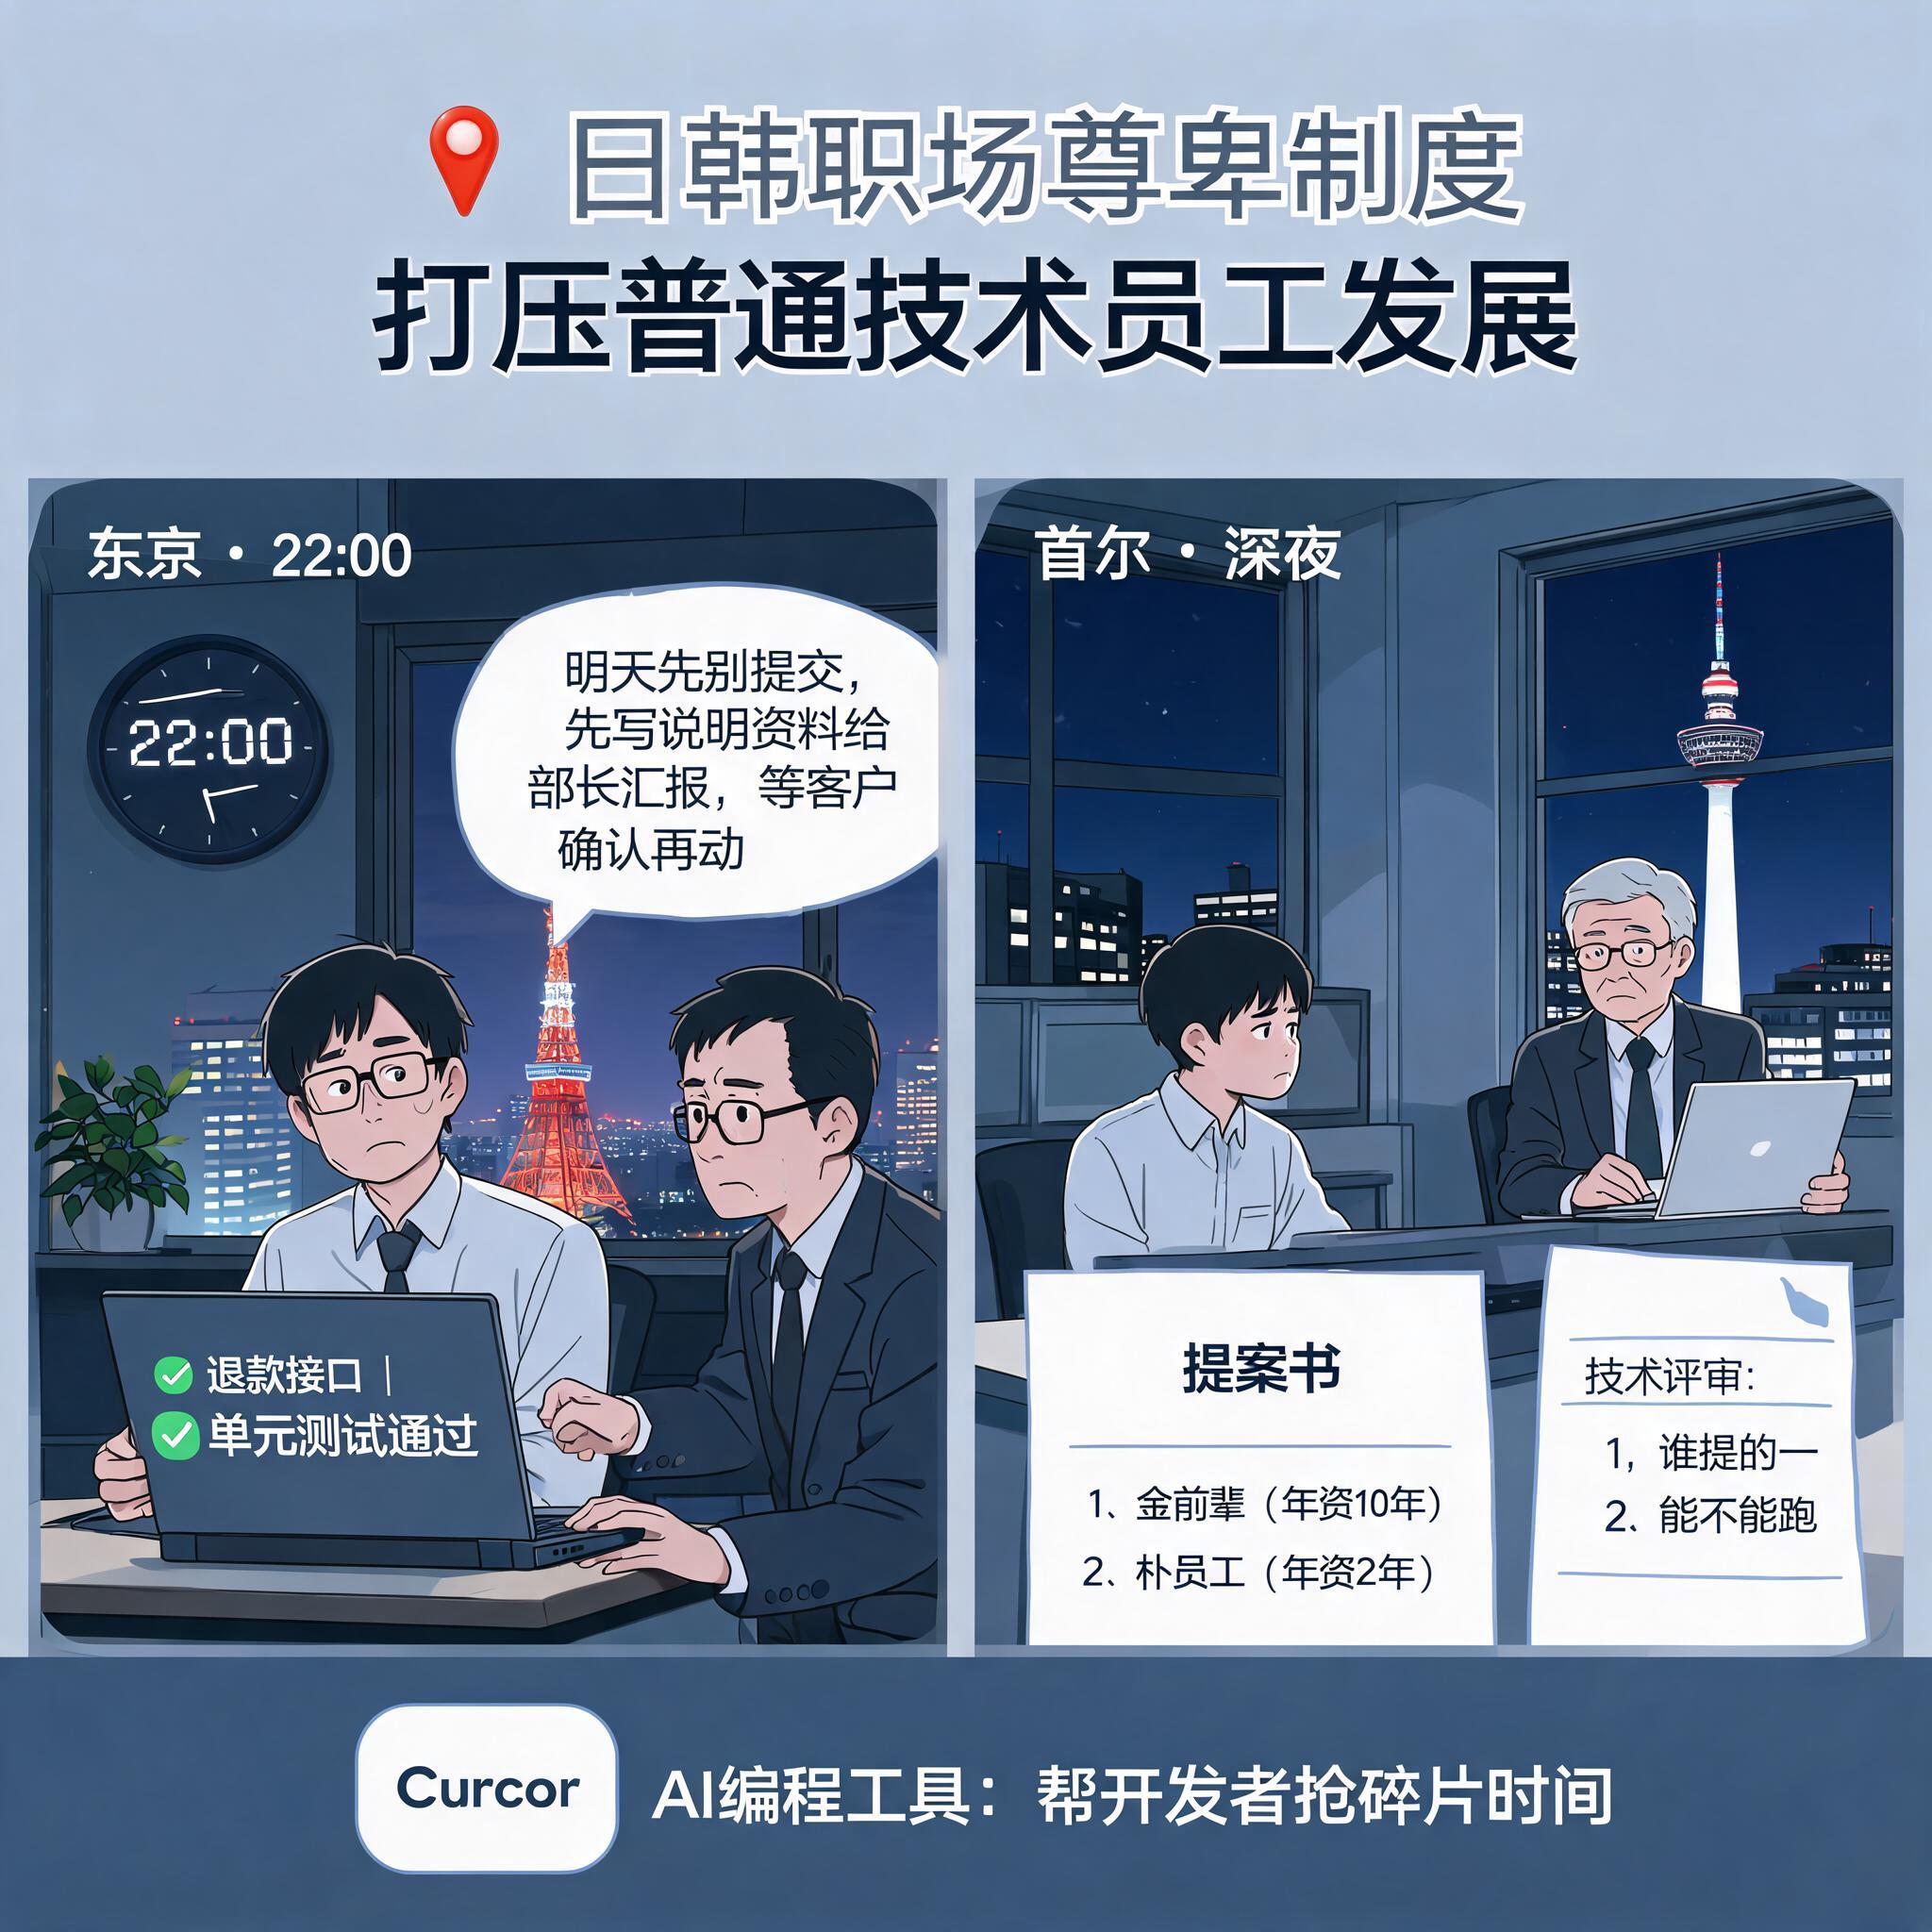
东京新宿,晚上十点四十。你刚把第三版式样书里被自己理解错的一处分支逻辑改完,组长走过来拍拍你肩膀,说了句「お疲れ様でした」,紧接着补一句:明天早上,能不能先跑一版出来看看。
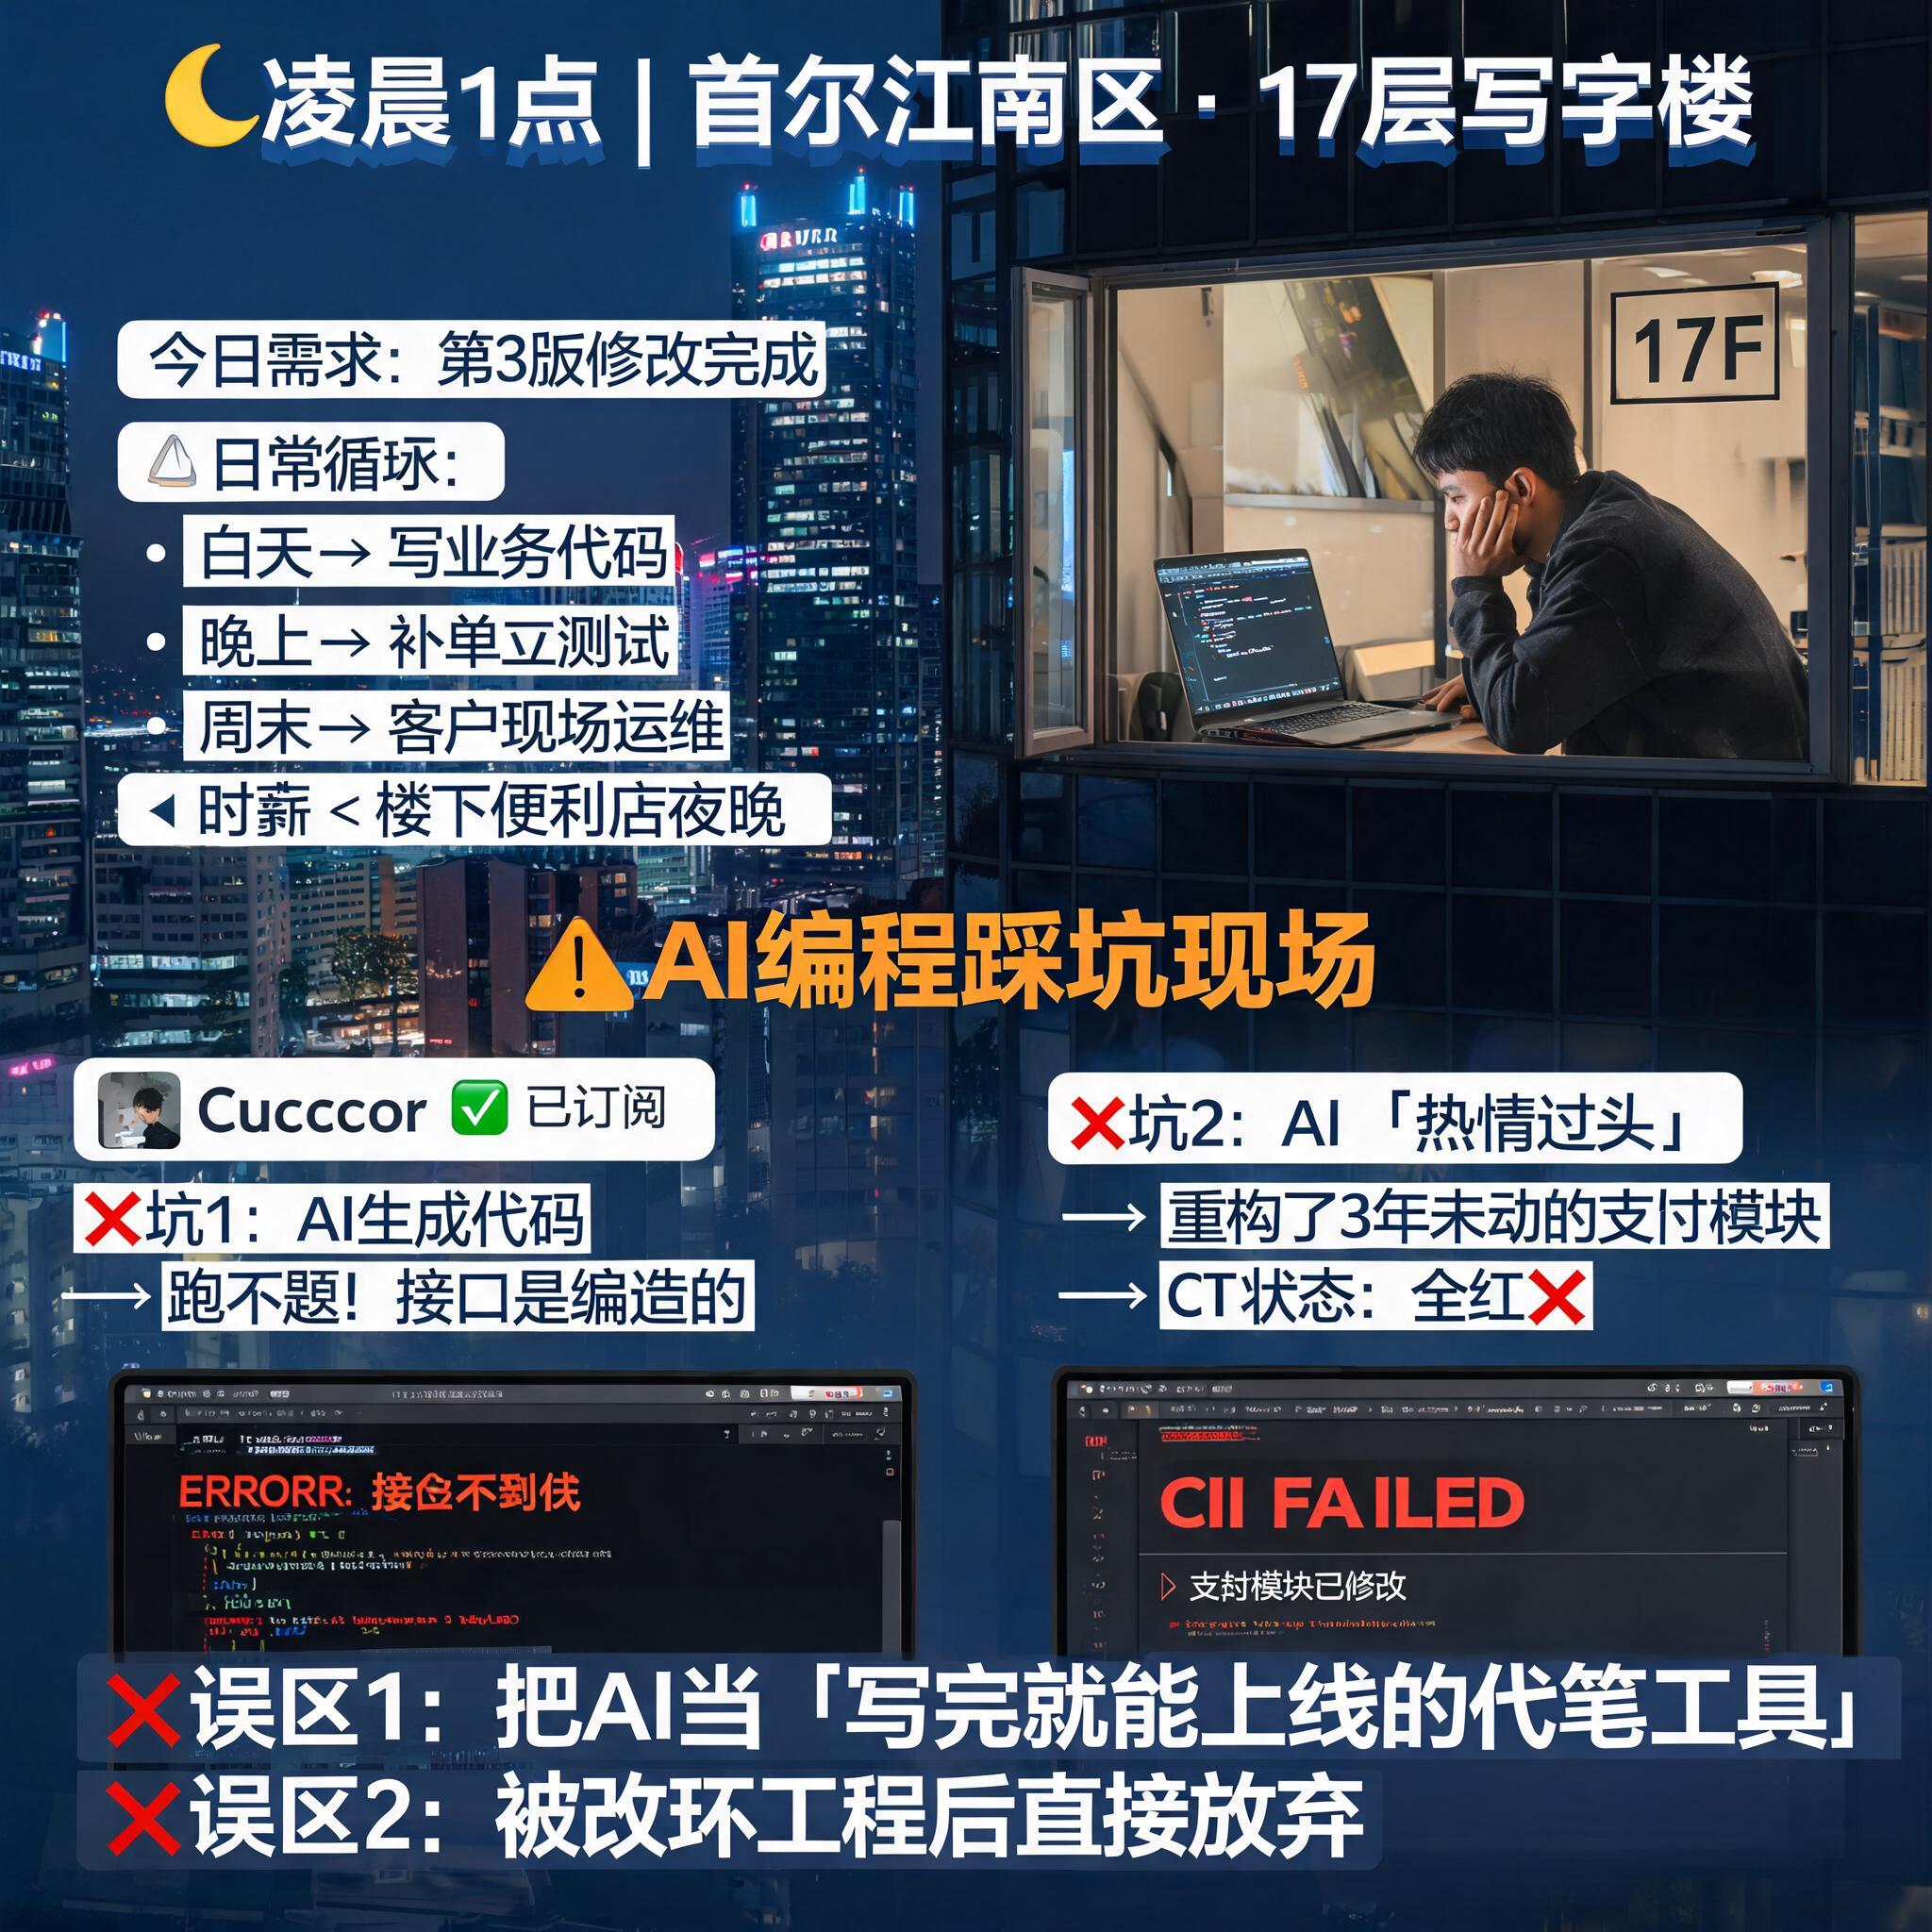
首尔江南,凌晨一点。客户方的确认邮件还没来。白天在会上拍板的需求,晚上在群里被推翻了一半。你所在的合作公司不能直接对客户说“这个需求有问题”,于是这半个晚上,你做的那件事叫“等”。
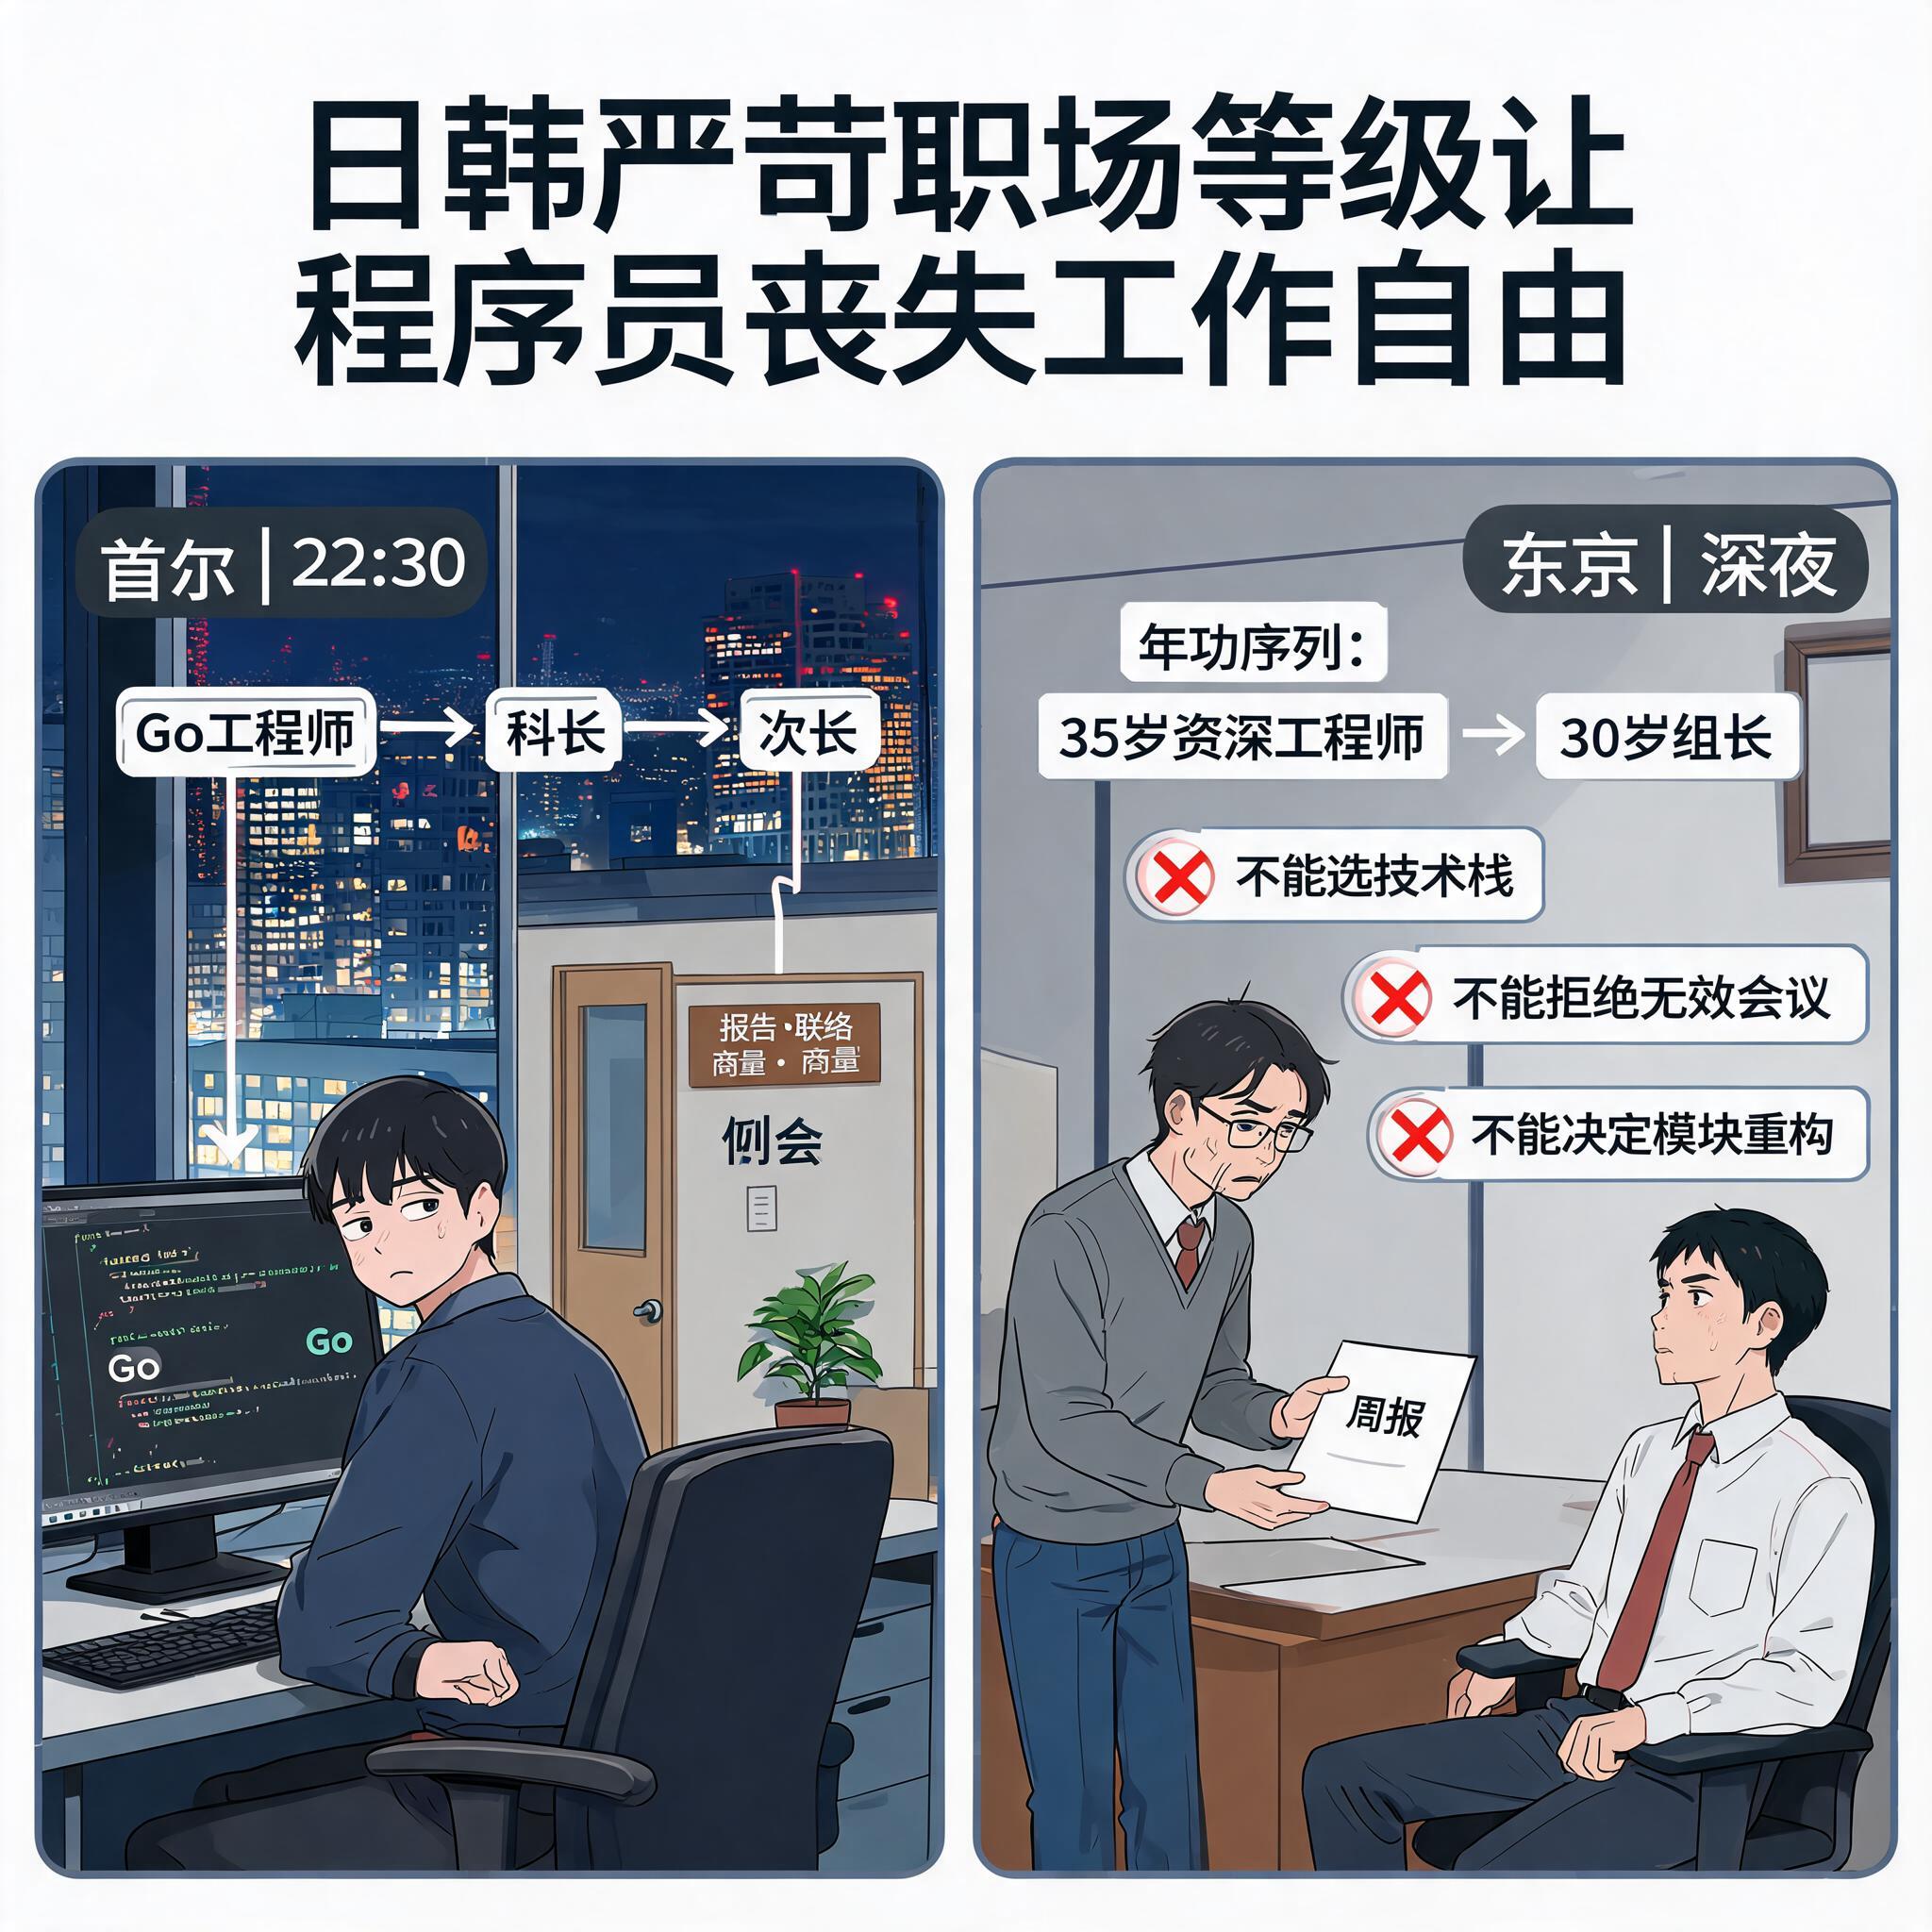
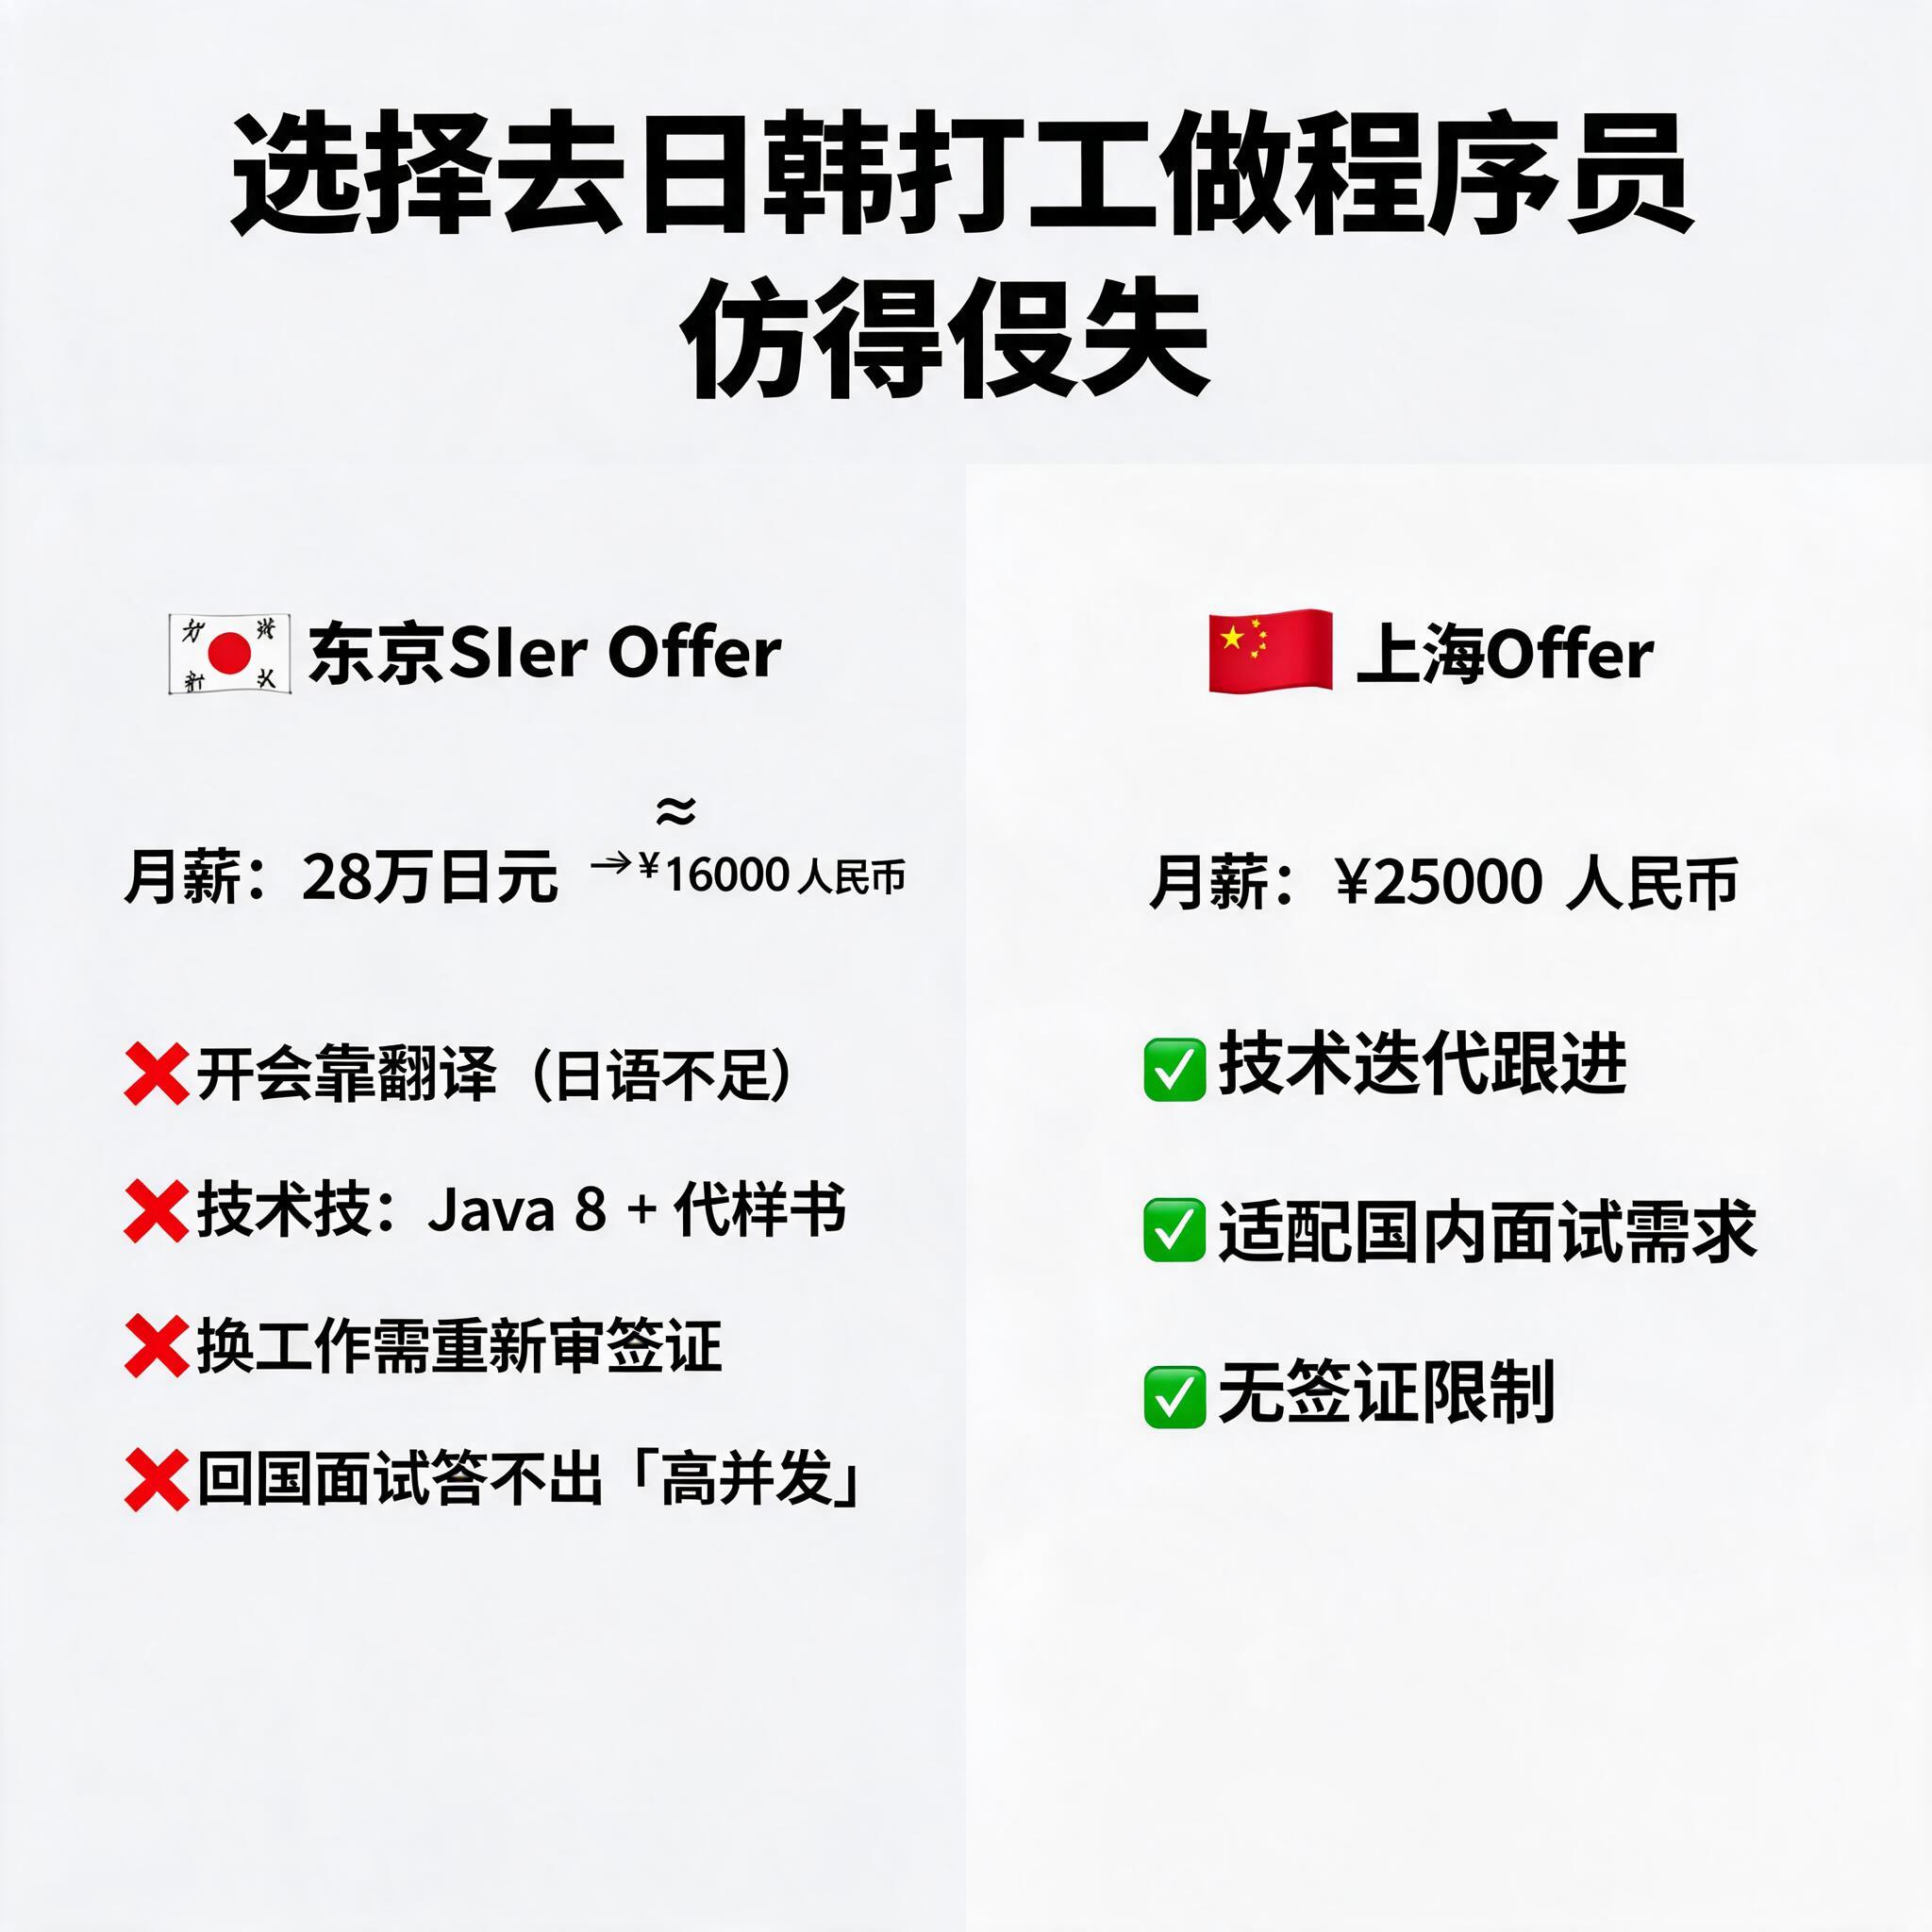
收入看着还行,扣完税和年金,房租一交,剩下的比在国内一线城市多不了多少。汇率一跌,同样的月薪换回人民币又少一截。加班却是实打实的:日本讲“报联相”,一件事要跟三个人确认;韩国讲层级,前辈没走你也不好先走。
这篇文章不劝你去或者不去。它只解决一个具体问题:在这种环境里,怎么用 AI 编码工具,把本来要耗掉你一整个晚上的时间抢回来。
一、两笔账,大多数人一开始就算错了
收入这笔账:你卖的不是技术,是稳定和忍耐
赴日韩做开发,尤其是通过派遣、常驻、或者当地合作公司进场的形式,单价里有一大块是“沟通成本”和“合规成本”,跟你的技术上限关系不大。也就是说,你代码写得再快,月薪也不会同比例上涨——这一点想清楚了,你就不会用“拼加班换加薪”的思路做决策。
前提条件要先问清:是正社员还是派遣?加班费按分钟结算还是包含在月薪里(日本叫“みなし残業”)?这些在你签合同前就该有白纸黑字的答案,别等到第一个月工资条出来才反应过来。
加班这笔账:真正吃掉时间的是流程,不是代码
一个典型晚上是怎么没的:
- 式样书是日文或韩文的,你的理解偏差在半路才暴露;
- 老系统没有文档,改一个字段要顺藤摸瓜找三张报表;
- 写完不敢提交,因为不确定有没有踩到别的地方,只能自己反复手测;
- 客户方评审排在两天后,你只能等,等的时候还被要求“先做点别的”。
这四件事里,只有第三件是写代码本身,其余三件全是流程摩擦。AI 工具最能帮上忙的地方,恰好就是这三件。
二、三个可以直接照搬的做法
做法一:动手前,先让 AI 把老工程的“地形图”画出来
操作步骤:
- 把你负责的那块目录、相关的接口定义、数据表结构,批量选中丢给 Cursor 的 Chat(不要开 Agent 模式,先只读)。
- 提一个非常具体的问题:“这个字段
xxx从写入到出现在报表上,经过了哪几个类和方法?按调用顺序列出来,标出文件名和行号。” - 拿到答案后,不要直接信。挑其中两个方法,自己点进去看,确认调用关系对得上。
- 对得上的部分,让 AI 再整理成一份 Markdown 笔记,存进仓库的
docs/目录。
一个真实场景:接手一个跑了八年的日本客户内部系统,Spring 分层混乱,Service 里塞着 SQL 拼接。要加一个“订单来源”字段并联动三张报表。按老办法,光摸清链路要一天。用上面的方式,二十分钟拿到一张调用草图,人工核对后修正了两处(AI 把两个同名的 getList 搞混了),剩下的时间直接用来改代码。当晚十点前提交,没熬到地铁末班。
注意:AI 对遗留代码的调用链推断,看的是文本相似度,不是运行时真值。凡是涉及动态代理、反射、AOP 的地方,它八成会漏。核对环节不能省,省下来的时间会以线上事故的形式还回去。
【金句:AI 能帮你画出老系统的地图,但地图上的路,你得自己走一遍。】
做法二:把日文/韩文需求先翻成“验收清单”,再翻成代码
操作步骤:
- 把式样书里涉及本次改动的段落整段贴给 AI,先让它输出“待确认问题列表”,而不是直接翻译。
- 你拿着这份问题列表去找组长或客户确认——这一步是给日韩项目量身定做的,那边最怕的就是你不问、自己猜。
- 确认完,再让 AI 把需求整理成 Given/When/Then 格式的验收条目,逐条对照,能写测试的直接写测试。
- 最后才让 AI 出实现代码。
为什么这一步绕不过去:日文式样书里“~の場合は”这类条件表达,翻译本身没歧义,歧义出在业务默认值上——客户脑子里有个“当然是这样”,文档里没写。先做问题列表,等于把这类隐形假设提前挤出来。等到代码写完再问,成本是重写。
注意:不要把未经脱敏的客户业务数据、真实用户信息贴进任何外部模型。字段名、表名能改写就改写,业务逻辑用假数据描述。这一条在日韩客户的项目里,往往是合同明文要求的保密条款,踩了不是技术问题。
【金句:AI 翻得准的是句子,翻不准的是客户没说出口的那半句。】
做法三:提交前补测试和边界,把返工挡在代码评审之外
操作步骤:
- 写完实现后,不要提交。选中改动的类,对 AI 说:“针对这个类的方法,列出 10 个容易出错的边界场景,只列场景,不写代码。”
- 你自己筛一遍,删掉不适用的,保留 4-5 个。
- 再让它按你保留的场景生成单元测试,运行,看红。
- 红灯修完,才推分支、开 PR。
一个真实场景:给一个金额计算模块加折扣逻辑,AI 一开始生成的实现没考虑“折扣后为负数”和“多币种汇率取整”两种情况。让它先列边界场景,这两条被列了出来(列场景比写代码更靠谱,因为它不需要猜上下文)。测试补上,评审时日本那边的技术Leader只在评论里问了一句汇率取值规则,没有像往常那样打回重做。
注意:AI 生成的测试通过,不代表代码对,只代表它与你的理解一致。测试用例的期望值必须你自己核对,尤其是金额、时间、分页这类地方。
【金句:AI 写的测试不能证明你对,但能证明你有没有想漏。】
三、五个最容易踩的坑
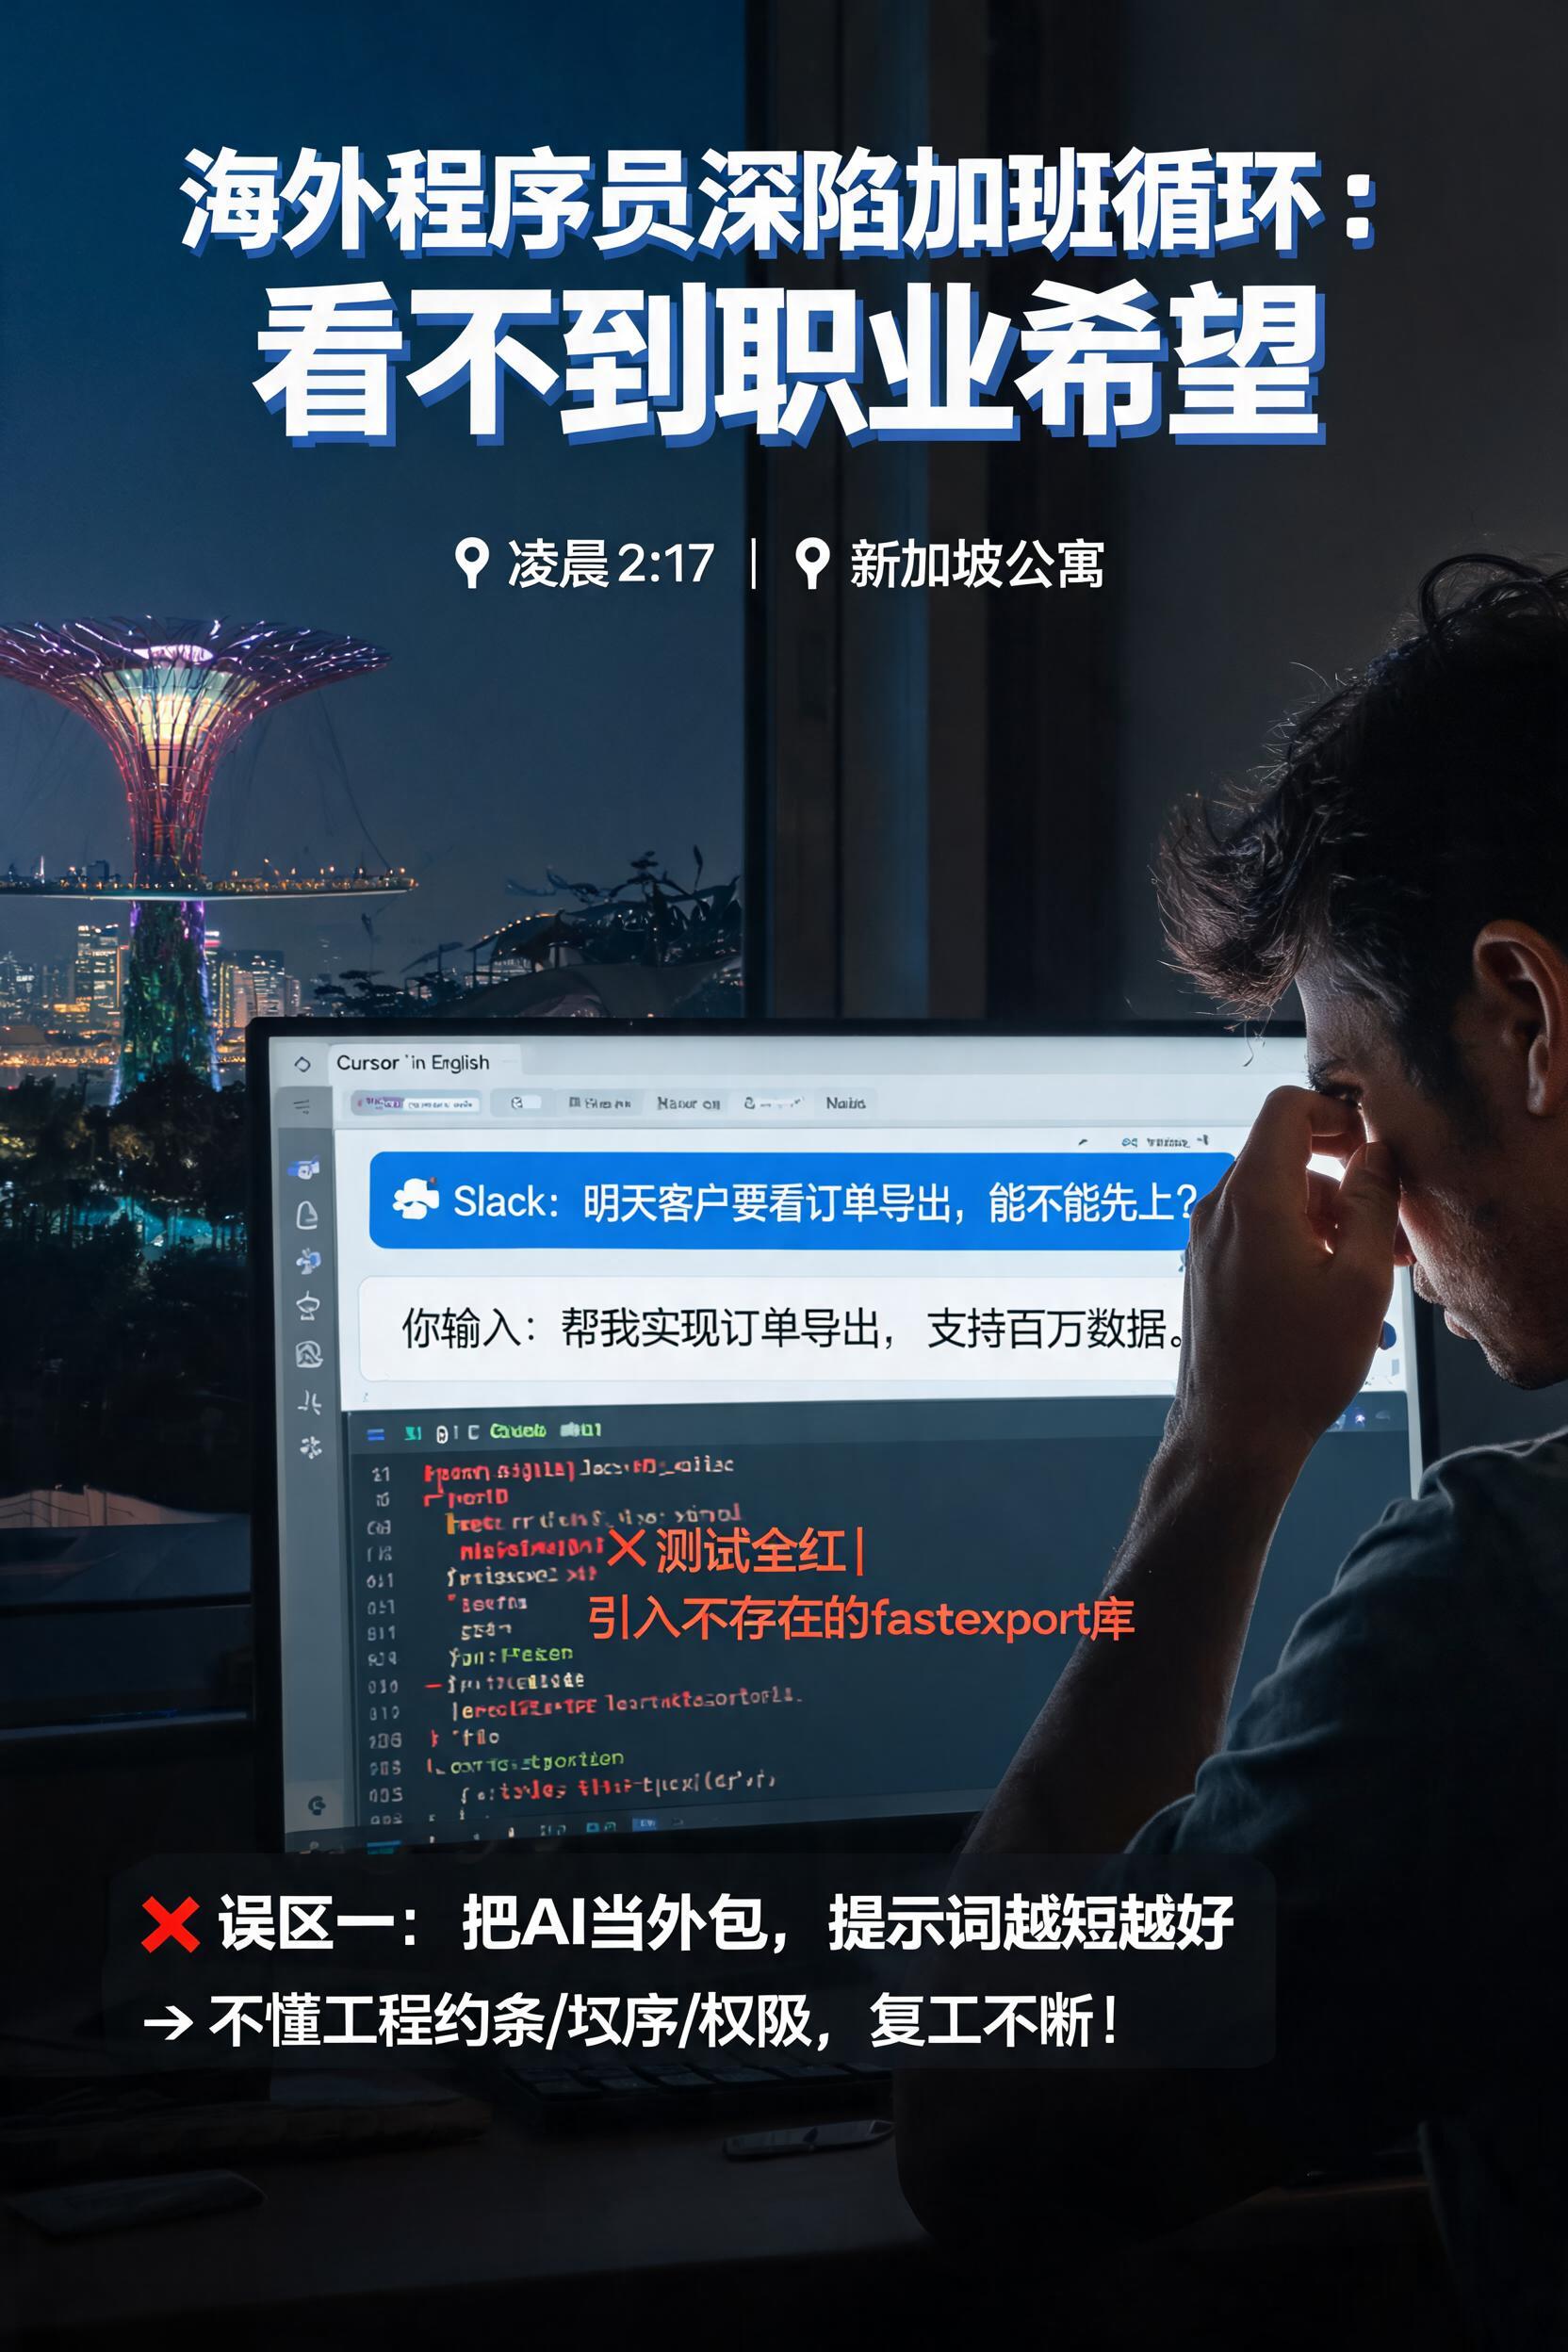
坑一:AI 编造不存在的 API 和配置项。
现象:生成的代码里出现看着很合理的 client.setRetryPolicy(...),实际这个版本根本没这方法。危害:编译能过就侥幸,过不了就白写半天。规避:让它生成的每一行外部调用,都在你项目的依赖版本里能搜到;搜不到的一律手写。
坑二:让 AI 大范围重构老工程。
现象:一句“帮我把这个类重构得清晰一点”,它给你换了 200 行。危害:在日韩客户的项目里,改动范围超标要重新走评审,还可能触发回归测试全量跑。规避:老代码只做最小改动,重构另开分支、另提申请。
坑三:把客户源码整段贴进外部模型。
现象:图省事,几十个文件一起丢进去。危害:触犯保密条款,后果不是被骂,是赔偿。规避:本地模型或公司内网工具优先;外部工具只贴改写过的片段。
**坑四:AI