日韩企业层级固化底层程序员难有出头之日
凌晨一点的品川,你和组长写的是同一类代码
晚上十一点半,东京品川。你把最后一个 catch 块补完,跑通单元测试,提交。隔壁工位的组长比你大十二岁,今天做的模块和你几乎一样——同一份详细设计书拆下来的同类型批处理。
差别在工资条上:他是你的两倍多。而且他前面还排着三个人,等着课长的位子空出来。
你把这段经历讲给国内的朋友听,对方第一反应是"那你跳槽啊"。问题是,你跳到下一家,结构还是这个结构。日本的 SI 圈子靠多重下请撑着——一次请负拿整体,二次请负拆模块,三次请负再拆成人和月。越往下,你接触到的只有详细设计书的下游,看不到需求怎么来的、架构为什么这么定、钱是怎么谈的。韩国那边换个词,职级序列、年功序列、正式职与非正式职的差异,卡点不同,结果类似。
这篇文章不聊情绪,聊两件事:天花板到底焊在哪一层,以及在这一层里,一个普通程序员还能靠什么把自己的产能和议价权拉起来。后半部分会落到具体的 AI 编程实操,因为这是我目前看到、对个体最有效的一根杠杆。
一、先看清:卡住你的不是能力,是结构
很多人以为升不上去是因为技术不够硬。你去翻一翻那些升上去的人写的代码,很多还不如你。真正卡住你的是三件事:
第一,你被隔离在价值链的下游。 上游做提案、做估算、和客户吃饭的那批人,掌握的是信息差;你在下游接收的是一份已经定死的规格书。规格书不会写"这里为什么不用消息队列",你也就永远学不到决策是怎么做的。
第二,年限被当成了能力的代理指标。 年功序列的逻辑是"待得久 = 靠得住",这在人员流动低的年代能用。现在技术栈三年一换,这套尺子量不准,但没人愿意换尺子,因为换尺子的人往往是尺子的受益者。
第三,你的产出很难被单独看见。 三层下请之后,交付物是"团队成果",你熬的夜被平摊进了一个巨大的分母。
所以你越努力,越像是往一个已经封顶的瓶子里灌水。 想出头,要么换瓶子,要么把自己变成能卖整瓶水的人。
【金句:结构性天花板从来不是靠加班敲开的,你得先找到门在哪。】
二、三个实操方法:用 AI 把自己从"执行位"挪到"交付位"
先说清楚:AI 编程工具解决不了职级问题,但它能改变一件事——同样八小时,你能交付的边界在哪。当你能一个人把一个完整模块从设计扛到上线,你在团队里的位置就变了。下面三个方法,都是我日常在用的,可以直接照搬。
2.1 先写契约,再让 AI 写实现
最没用的问法是"帮我写一个订单超时的处理逻辑"。AI 会给你一段看起来很漂亮、但和你项目里任何东西都对不上的代码。
正确的顺序是反过来:你先把接口定死,再让它填肉。
具体步骤:
- 手写(或让 AI 帮你补全)接口签名、入参出参的 DTO、错误码枚举、幂等键的设计。
- 把边界条件用注释写在函数上方:超时多久算超时、重试几次、失败后落到哪张表。
- 这时候再把整个文件丢给 Cursor,说"按已有契约实现函数体,不修改签名和错误码"。
我上个月给一个老系统加限流,契约先定死 RateLimiter#tryAcquire(key, permits) 和 RateLimitExceededException 的错误码,实现交给 AI。它一次成型,我只改了两处日志格式。如果我一开始就让它"实现一个限流器",它大概率会引入 Redis 客户端、引入一个我没用过的注解、再顺手把我项目里的 Spring 版本降一级。
2.2 给项目配一份 AI 规则文件
每次开新对话都要重复"我们用 JDK 17、不用 Lombok、日志用 SLF4J、异常统一走 XxxException",这本身就是浪费。
用 Cursor 的 Rules(.cursor/rules 目录,或项目根目录的规则文件)把项目约定写成一份常驻上下文:语言版本、依赖黑名单、命名规范、测试框架、禁止的写法、目录结构说明。写一次,之后每次对话它都带着这套约束。
我给一个韩方团队的老 Java 项目加规则文件时,特意写了一条"禁止引入任何新的第三方依赖,除非在对话中明确说明理由"。这条规则挡掉了至少五次自作主张的引入。
2.3 一次只让它动一个函数、一个文件
这是最容易执行、也最救命的一条。
AI 最擅长的不是写一行代码,是大范围重写——它会把你的类拆了、改包名、动 import、顺手"优化"掉你没让它碰的逻辑。等 git diff 出来,一千行改动,你想 review 都无从下手。
我的做法是:每次任务开始前先 git commit 一次,然后明确告诉它"只修改 XxxService.java 中的 calculate() 方法,其他文件不要动"。改完立刻 git diff 扫一遍,确认改动范围可控再继续下一步。
把 AI 当成一个手速极快、但从没在你项目里干过的外包。 你会给外包多大的改动权限,就给它多大。
【金句:AI 的产出质量,取决于你把边界画得多清楚;边界模糊,它就替你瞎猜。】
三、五个高频坑,踩过一次就够疼
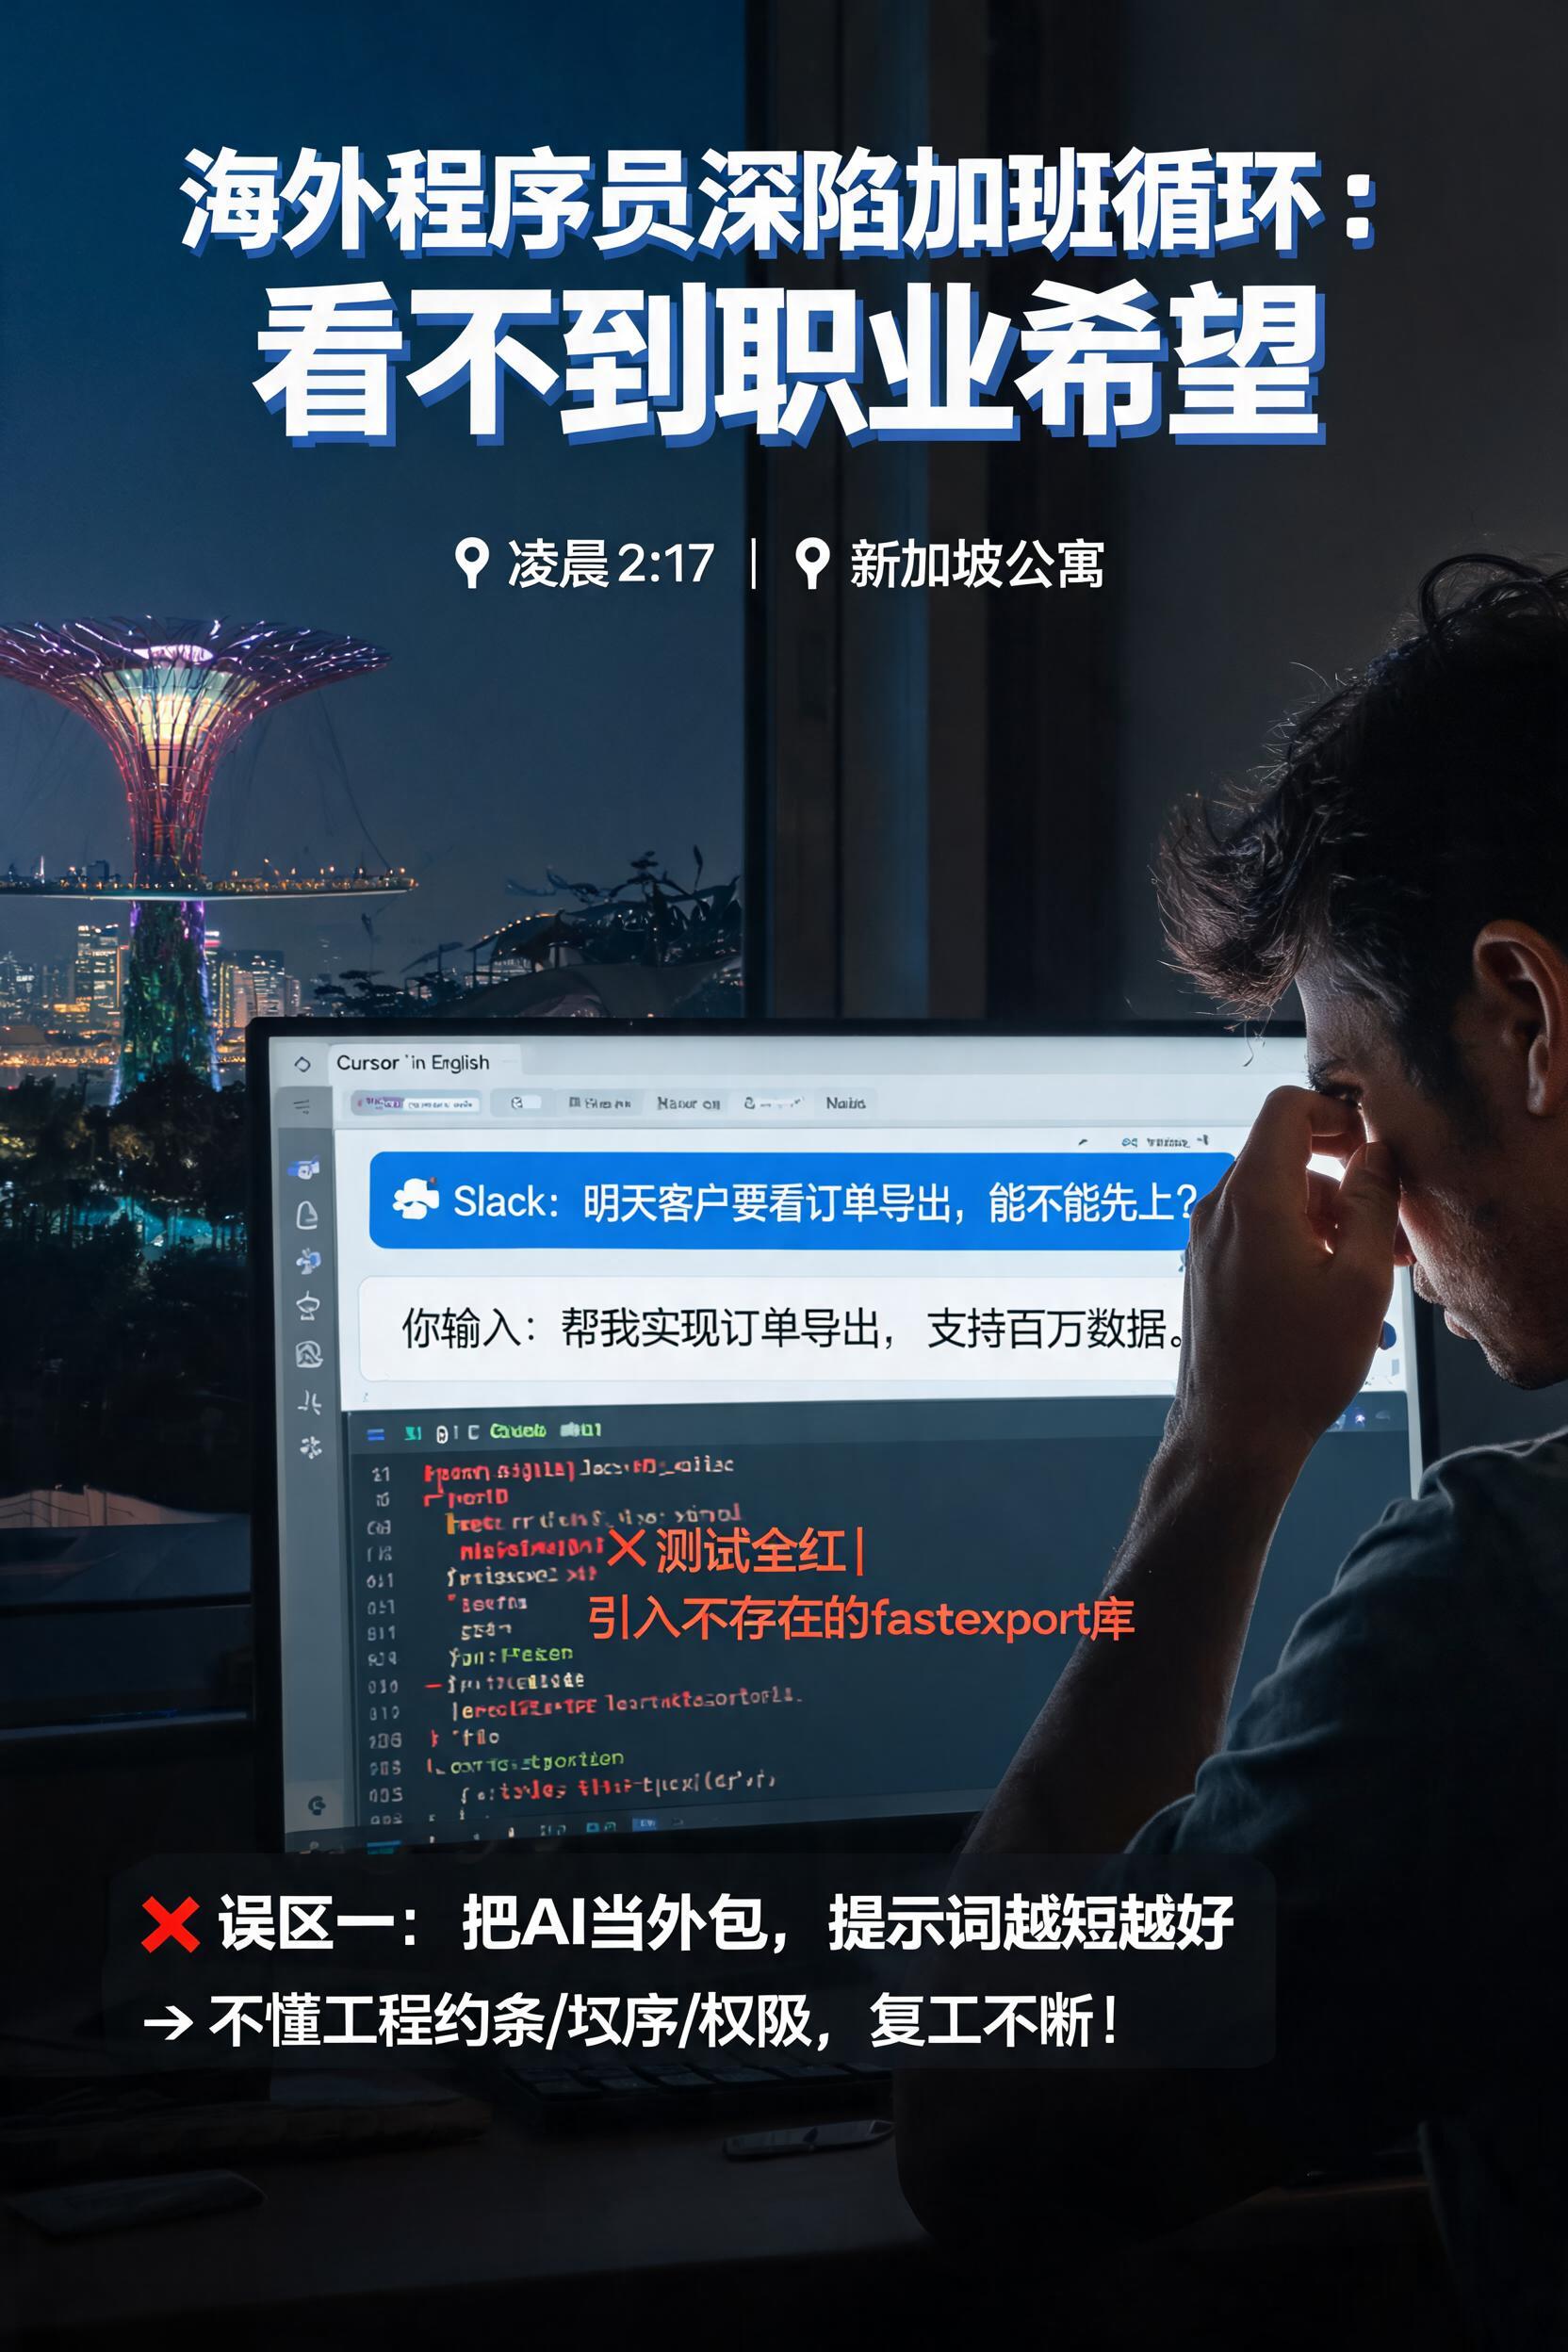
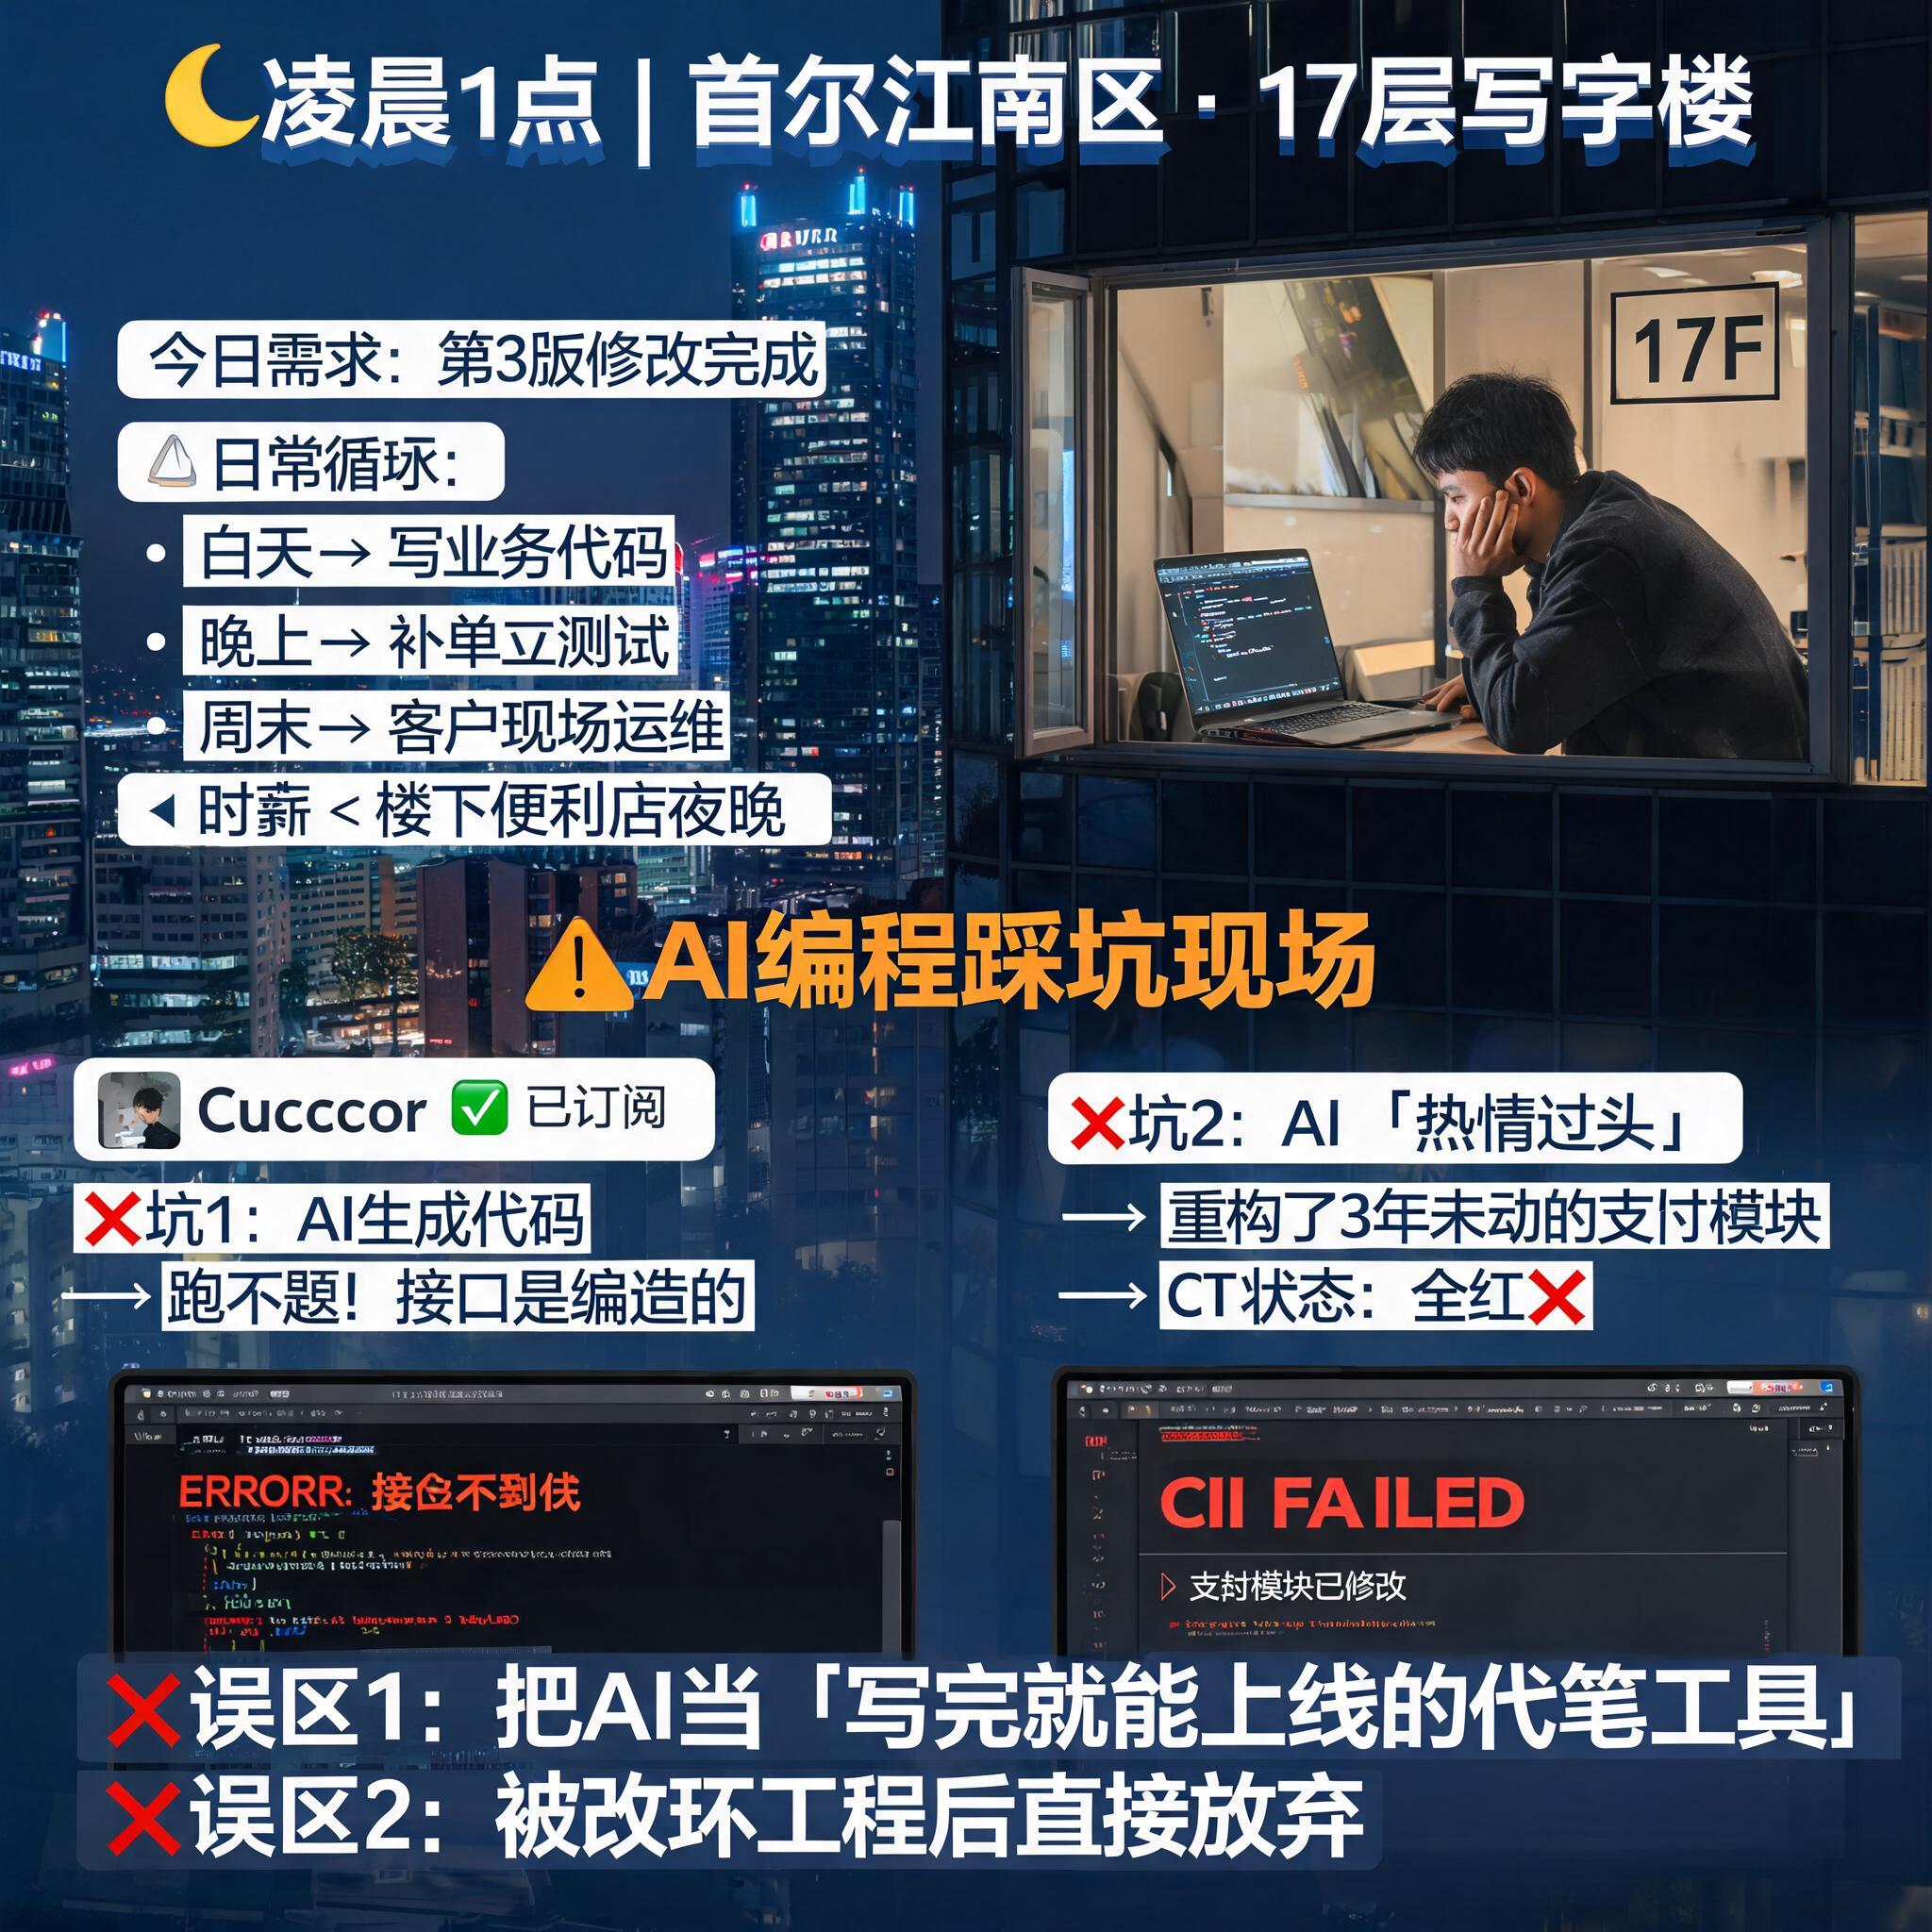
坑一:幻觉出不存在的 API。
现象是它给你一个方法名,看着很合理,一编译就报不存在。危害是你可能花半小时查文档,最后发现是编的。规避办法:让它实现之前先让它列出要用到的所有方法签名,你确认签名存在再让它写。
坑二:一口气大重构。
现象是你说"优化这个类",它把整个类拆成五个文件。危害是老工程被改坏,回滚成本高。规避:改动前 commit,任务拆分到单个方法级别。
坑三:上下文污染。
现象是你让它读整个仓库,它把某个废弃目录里的老写法当成了当前规范。危害是生成一堆风格冲突的代码。规避:只 @ 你真正需要的文件,别图省事丢整个 repo 进去。
坑四:假通过的测试。
现象是它写的单元测试全绿,但你一看全是 mock,把被测逻辑也 mock 掉了。危害是上线后才发现真有问题。规避:要求它至少写一条不走 mock 的集成测试,或者你自己补一条真实数据的用例。
坑五:你自己看不懂它写的代码。
现象是代码能跑,但你不知道为什么会跑。危害在代码评审时暴露——同事问你这里为什么这么写,你答不上来,信任直接掉一档。规避:任何一段你不理解的代码,要么让它逐行解释到你懂,要么就自己重写。
这五个坑的共同点是:省下的时间,最后都以别的方式还回去了。 而且还得带上利息。
【金句:能跑起来的代码不等于你交付的代码,理解不了的部分迟早会回来找你。】
四、一次完整复盘:给老系统加一层缓存
背景是老系统一个查询接口,QPS 一上来数据库就扛不住,要求一周内上线缓存。任务不小,但结构清晰,正好适合拿来跑一遍流程。
第一步,我没有直接说"加个缓存"。 我先自己列了四件事:缓存什么键、过期策略、缓存穿透怎么挡、更新时怎么失效。写成一个简短的需求说明丢给 AI,让它先出方案对比,不要写代码。
它给了三套:本地 Caffeine、Redis 单层、Redis + 本地二级缓存。中间它还建议了一个我没考虑过的点——热点 key 的过期时间加随机抖动,防止同一秒集体失效。这条我采纳了。
第二步,定契约。 我把 CacheService 的接口、序列化方式、key 命名规则写死,再让它实现。
第三步,出问题了。 它实现缓存失效时,在写路径上直接 delete(key),但我们的读路径是二级缓存,本地那一层不会跟着失效。我让它把方案重做,改成发一条失效消息。这一步它第一次的产出完全不能用,因为我一开始没把"两级缓存"这个前提说清楚。
第四步,小步验证。 我让它只改 OrderQueryService 一个方法,加缓存调用;本地缓存层的改造另开一次对话。每次改完先跑测试,再 git diff 确认范围。
最终结果: 接口 P99 从 800ms 降到 40ms 左右,上线后没出故障。整个任务从调研到上线用了四个工作日,其中大概一天半花在方案讨论和契约定义上——真正写代码的时间反而最少。
这也是我最大的感受:AI 把写代码这件事的成本压下去了,于是定义问题的成本相对抬起来了。谁更会定义问题,谁的产出就更值钱。
五、可以马上动手的三件事
- 今天给你的主力项目写一份规则文件。 五行也行,把语言版本、依赖黑名单、命名规范写进去,观察一周内 AI 产出的风格是否收敛。
- 挑一个你熟悉的小任务,强制走一遍"契约先行"流程。 先写接口和边界条件,再让 AI 填实现,对比一下和你过去直接提问的差别。
- **下一次改动前