日韩 IT 公司底层程序员常年透支身体换微薄薪水
日韩 IT 公司底层程序员常年透支身体换微薄薪水
东京新宿,凌晨一点二十。
某 SES 公司(日本那种一层套一层的软件外包)的办公室还亮着灯,工位上坐着七八个人,没人说话,只有机械键盘的响。末班电车 23:47 已经开走了,公司规定打车费最多报 3000 日元,剩下的自己掏。
第二天早上 9 点半,人还得准点坐在客户现场的工位上,对着甲方组长点头问好。
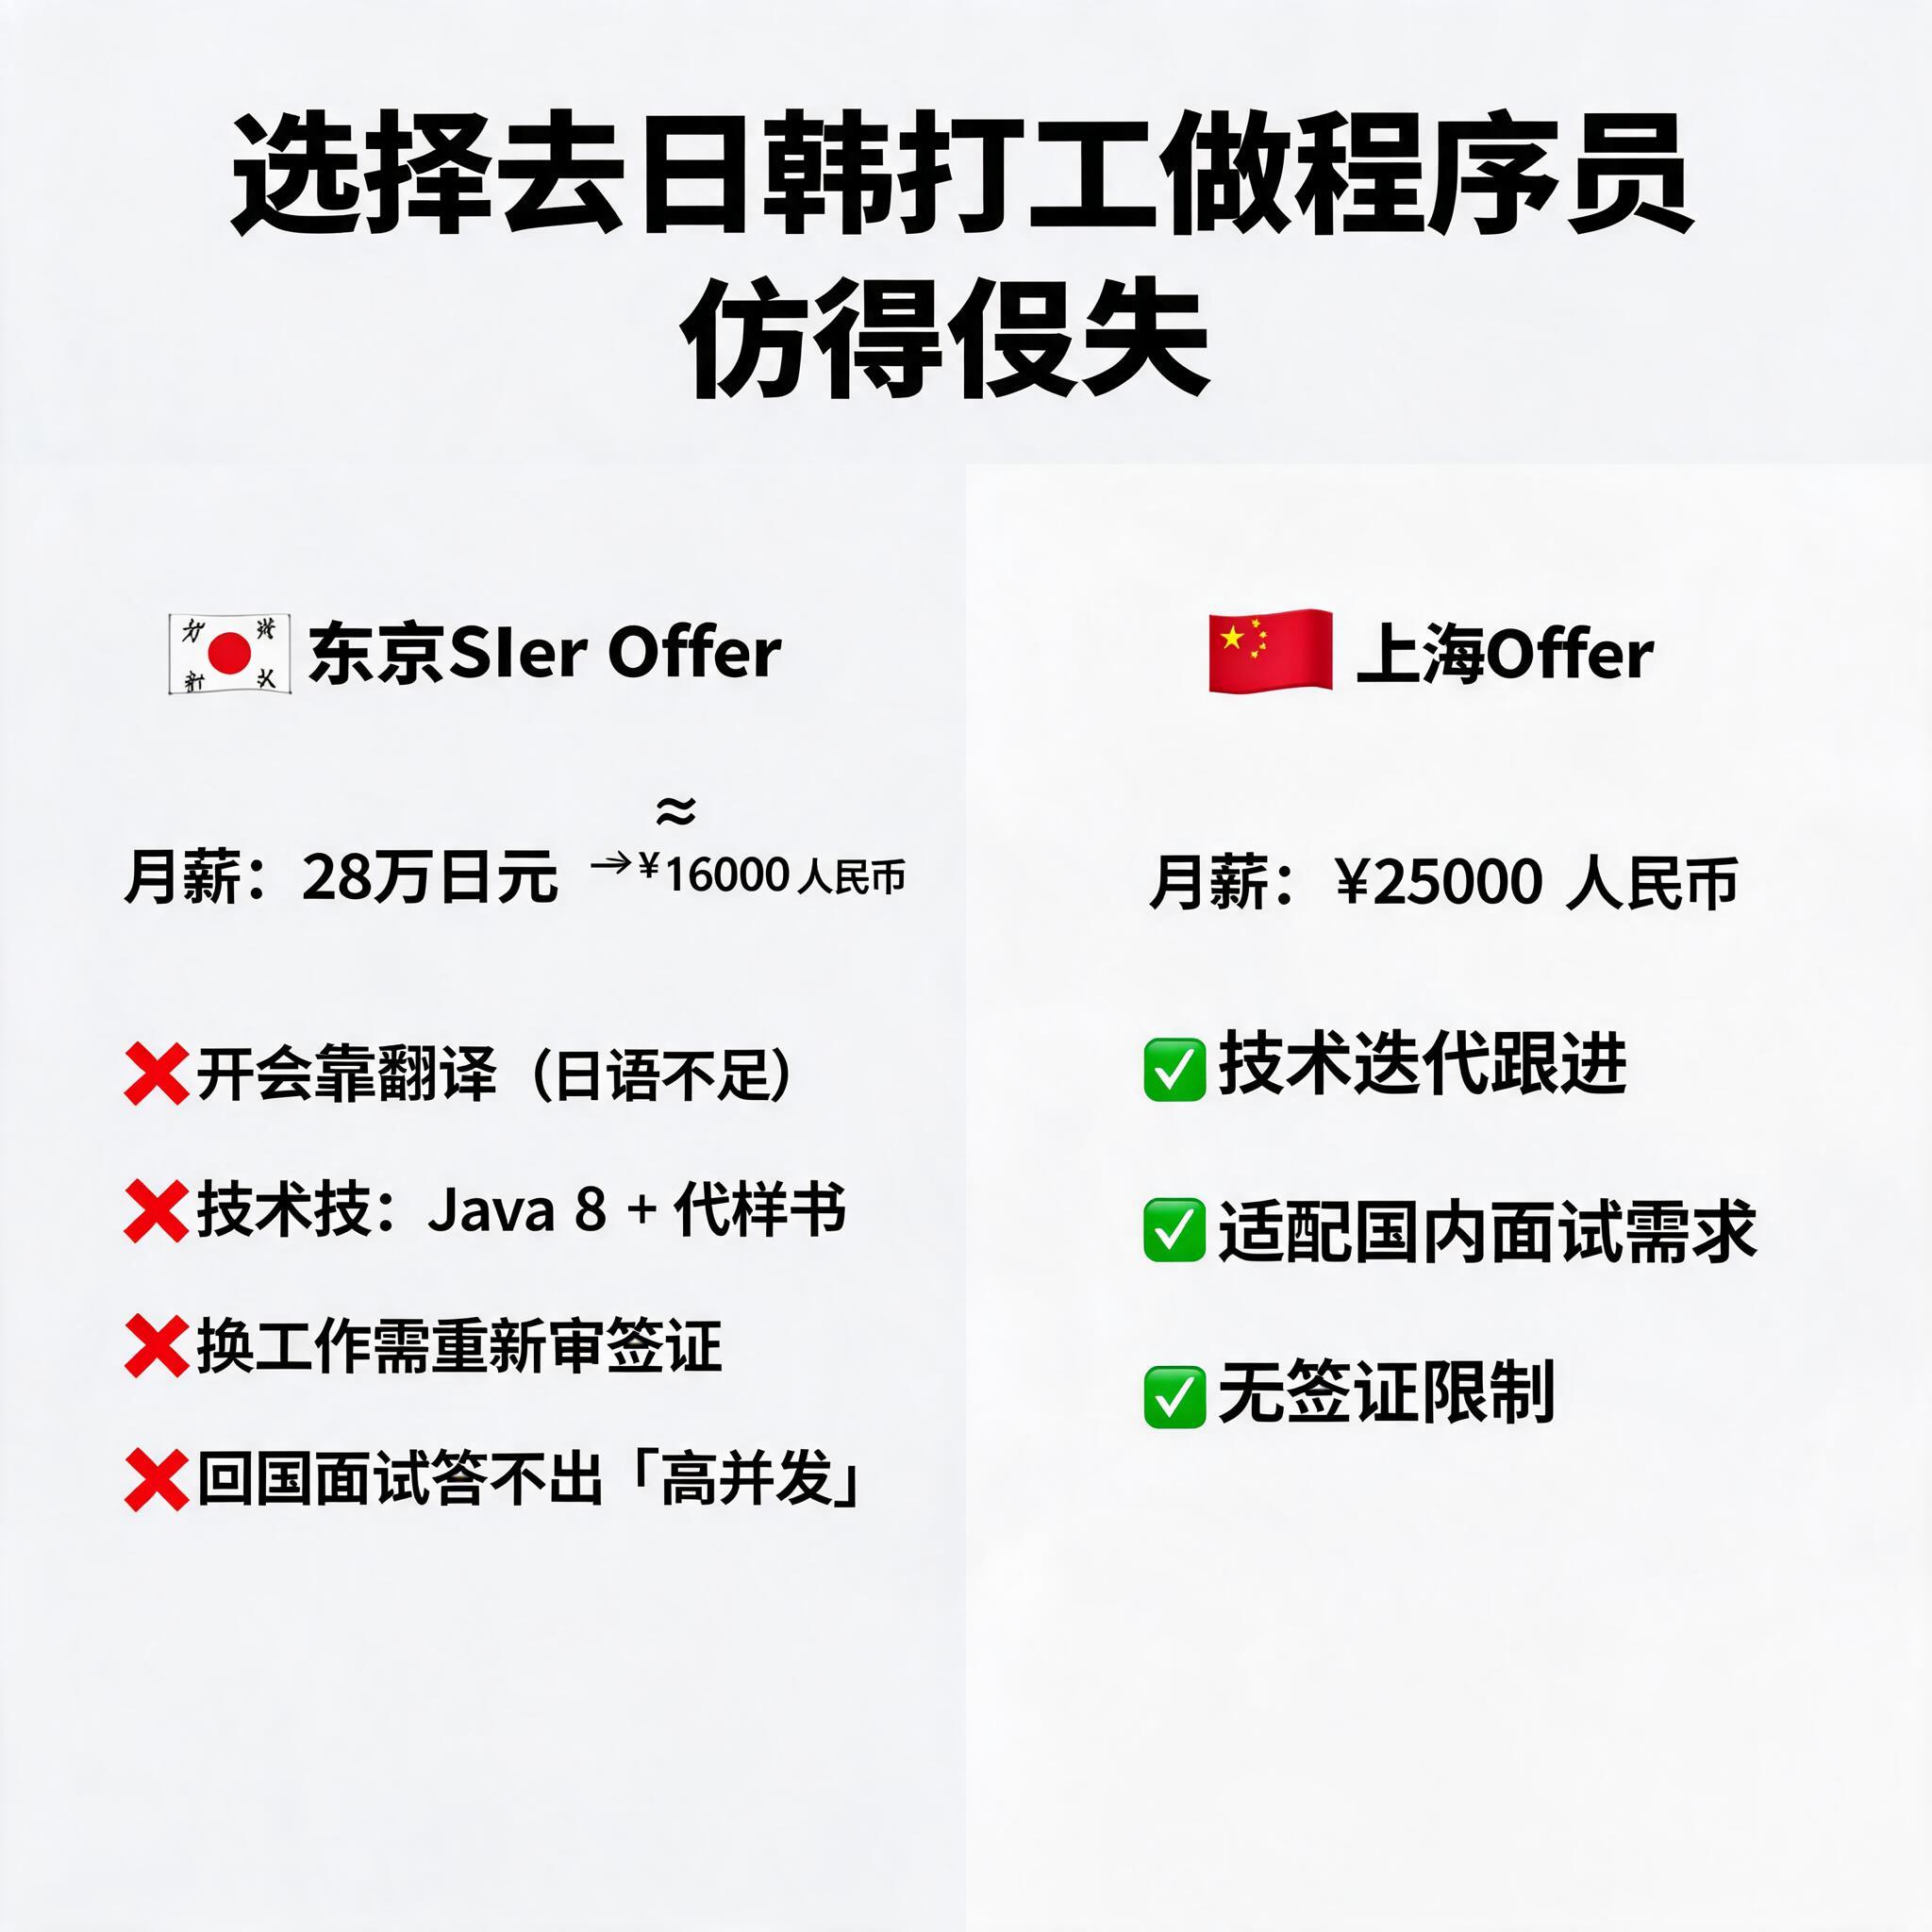
月底到手 24 万日元出头。房租 8 万,国民年金和保险扣掉一大块,剩下的钱,刚够在这个城市维持一个"看起来还过得去"的生活。
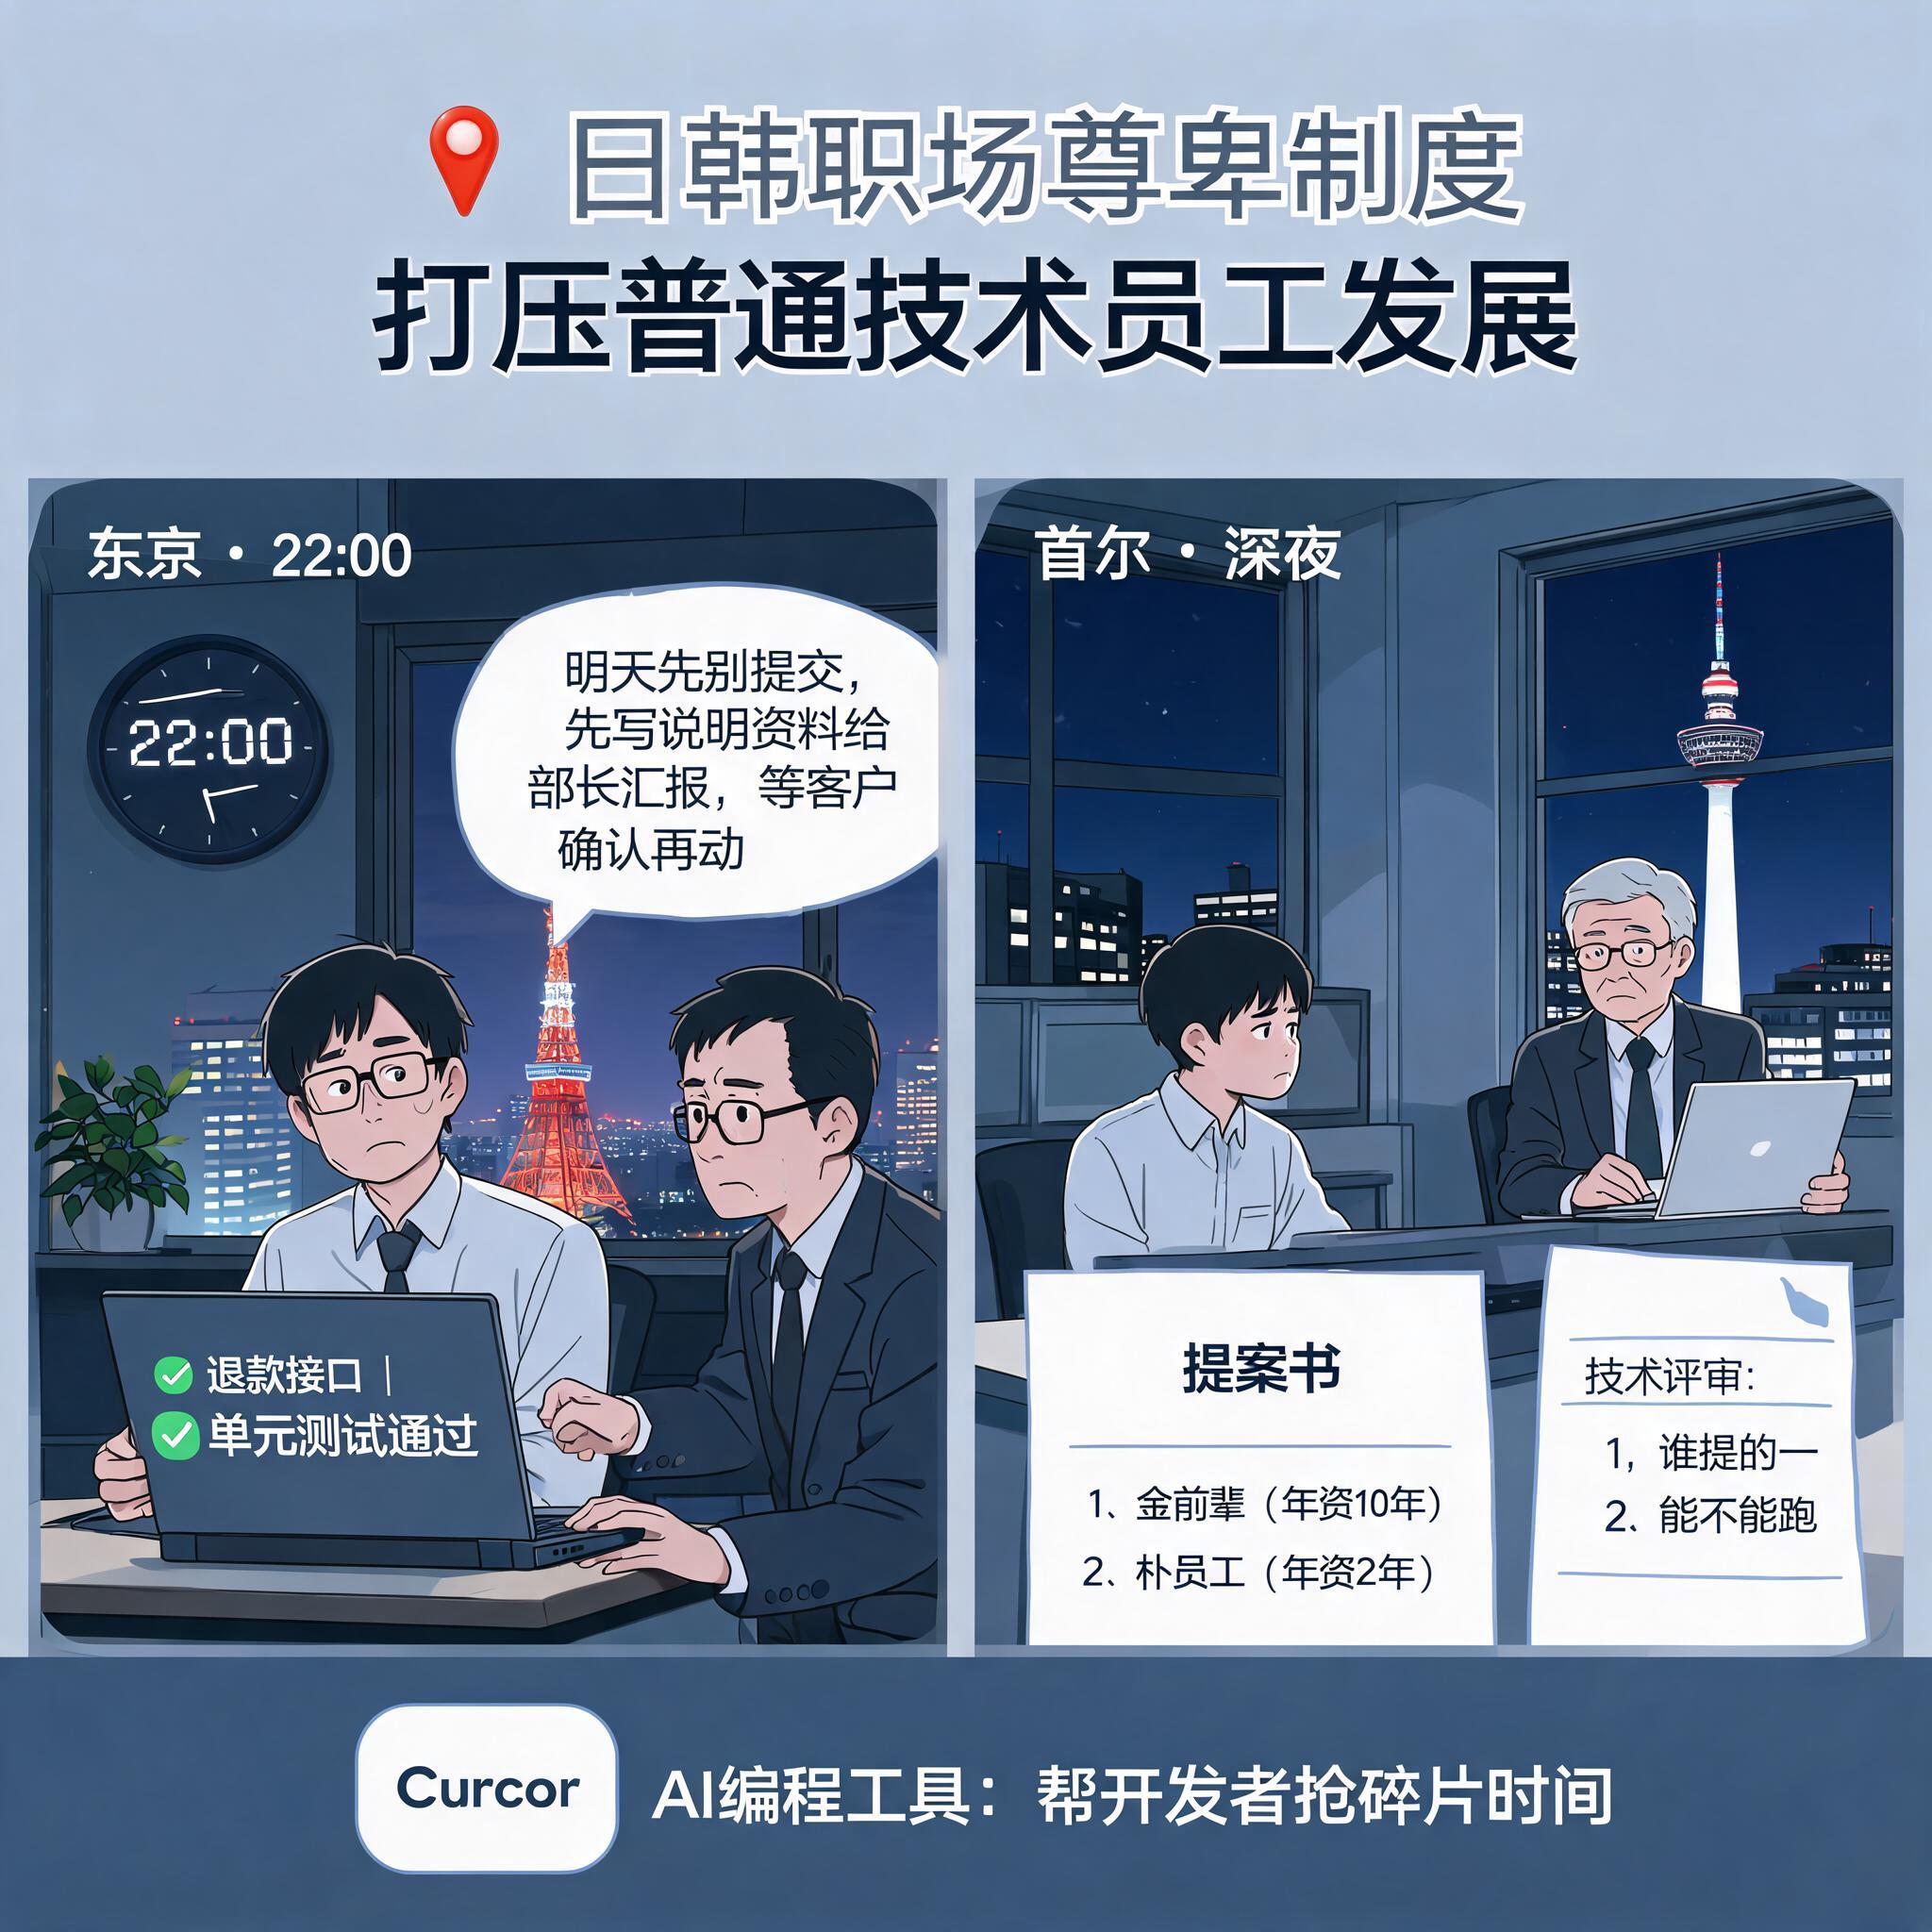
韩国那边的同行,处境差不多。中小 SI 公司,年薪 3000 万韩元左右,做的项目是给本地制造业客户改 ERP 和报表系统,代码风格停留在大学作业水平,改一个字段要过三道审批。
我写这些,不是为了贩卖焦虑。是想说清一件被很多人忽略的事:这类工作的核心问题,是时间被大量消耗在"重复劳动"上,而重复劳动恰好是现在最容易被自动化掉的那部分。
而真正能把你从这种循环里捞出来的,恰恰是很多人用错了的 AI 编程工具。
大多数人用 AI 写代码,卡在两个误区里
误区一:以为 AI 应该"一键写完整个功能"。
于是你让它生成一个带分页、带导出、带权限校验的模块,它噼里啪啦吐出来 400 行,你贴进项目,跑不通。你打开一看,自己都读不懂它写的 SQL 联表逻辑。
误区二:把 AI 当成一个高级搜索框。
问一句"Express 怎么做审计日志",复制一段代码,粘进去,报错,然后得出"AI 也就那样"的结论。
这两种用法的共同点是:你从头到尾没给它任何关于"你的项目"的信息。 它只能按互联网上最通用的写法糊弄你,而你的项目是一个跑了五年的老系统,到处是和通用写法不一样的坑。
下面三个做法,是我在外包项目里反复用过的,能直接照搬。
一、把重复劳动从你身上剥下来:3 个能照搬的做法
1.1 先让 AI 读你的项目规矩,再让它动笔
外包项目最要命的一点:每换一个客户现场,代码风格、目录约定、依赖版本全都变一遍。你每天有一半时间在"适应别人的烂摊子"。
解决办法是给它立规矩。
操作步骤:
- 在项目根目录建一个
.cursorrules(或AGENTS.md,看工具支持),写清楚这几件事:语言和版本、框架版本、目录结构约定、命名风格、禁止引入的新依赖、错误处理统一方式。 - 控制在 20~40 行。写太长它记不住,写太短没用。
- 每次开新对话,先让它复述一遍规矩,确认无误再让它写代码。
注意: 项目里如果有历史遗留的"脏"写法(比如所有查询都走一个叫
db.query()的自研封装),一定要在这一步写进去。不写,它就会自作主张给你换成 ORM。
我给一个日本客户的老 PHP 系统(5.6 升到 8.1 之后)加数据导出功能,第一版直接让它写,它用了 Composer 包,而客户现场不允许联网装依赖。加上规则文件之后,明确写了"只能使用 PHP 内置函数和项目已有的 lib/ 目录",第二版一次就跑通了。
这一步花 30 分钟,能省掉后面十几次来回拉扯。
【金句:AI 写不出你项目里的潜规则,除非你先把潜规则写在它能看见的地方。】
1.2 一次只改一件事,逼它交"最小 diff"
AI 改代码最大的破坏性,在于它会顺手"优化"你没让它动的地方。你让它加个字段校验,它把你整个 service 层重写了一遍。
操作步骤:
- 第一轮不要代码。 让它只输出方案:要改哪几个文件、每个文件改什么、会不会影响其他调用方、有哪些副作用。
- 你逐个确认,一次放行一个文件。
- 每改完一个文件立刻
git commit。改崩了,git reset --hard就是一步。对话记录不要扔,出问题能回看它是怎么想的。 - 拒绝"顺手重构"。在提示词里直接写:不要修改我未指定的任何文件。
这套流程看起来慢,实际比"一口气生成 400 行然后 debug 三小时"快得多。
1.3 让它写验证代码,别让它替你写业务逻辑
老系统最怕的不是改不动,是改完不知道有没有改坏别的地方。
操作步骤:
- 拿到要改的模块,先让 AI 写测试或复现脚本,在当前(未修改的)代码上跑通,确认它复现了现有行为。
- 再让它改业务代码。
- 重新跑测试,对比结果。
这个顺序反过来,你就是在给一个你无法验证的黑盒背书。测试用例你可以一行行看懂,业务代码它写错的地方你未必看得出来。
前提条件: 如果模块有外部依赖(数据库、第三方 API),先让 AI 帮你写好本地 mock,否则测试跑不起来,这一步直接作废。
【金句:让 AI 写测试,是让它给自己的作业打分;让 AI 直接写业务,是你替它背锅。】
二、五个最容易踩的坑
坑 1:幻觉 API 和幻觉依赖。
现象:它调用了一个你装不到、甚至根本不存在的库方法。
危害:报错排查花掉的时间,比你自己写还长。
规避:规则文件里写死依赖白名单;拿到代码先看它的 import 语句,一个都不认识就直接打回。
坑 2:一口气改十个文件。
现象:diff 铺满整个屏幕,你根本 review 不过来。
危害:出问题时你连回滚到哪一步都不知道。
规避:一次一个文件,一次一个 commit。这条没有例外。
坑 3:上下文污染。
现象:你在同一个对话里问了三个不相干的模块,它开始把 A 模块的方案套到 B 模块上。
危害:错误极其隐蔽,往往上线后才炸。
规避:一个任务一个对话。切换任务就开新会话,把规则文件重新加载一次。
坑 4:它顺着你的错误前提往下编。
现象:你说"这个接口应该是 GET 请求",它立刻点头,然后基于这个是错的假设写了一整套代码。
危害:方向错了,后面全部白干。
规避:在提示词里加一句"如果我的描述与代码实际情况不符,直接指出来,不要顺着我说"。
坑 5:让它处理你完全没读过的代码。
现象:你把一个陌生的核心模块丢给它,让它"优化一下"。
危害:它能跑,但没人知道它做了什么。这在受监管的金融、医疗项目里是事故。
规避:先让它解释这段代码在干什么,你确认理解之后,再讨论改动。
【金句:AI 让打字变快了,但它不会替你承担判断失误的后果。】
三、一次完整复盘:给五年老系统补审计日志
背景(脱敏): 首尔一家 20 人的物流 SaaS 公司,Node + Express + 裸 mysql2,没有 ORM,47 个接口散在 routes 目录里,跑在客户自建机房。
任务: 给所有写操作补一条审计日志。
第一步,先梳理,不写代码。 提示词原文:
不要写新代码。扫描 routes/ 目录,输出一份清单