海外码农常年无休加班掏空个人身体
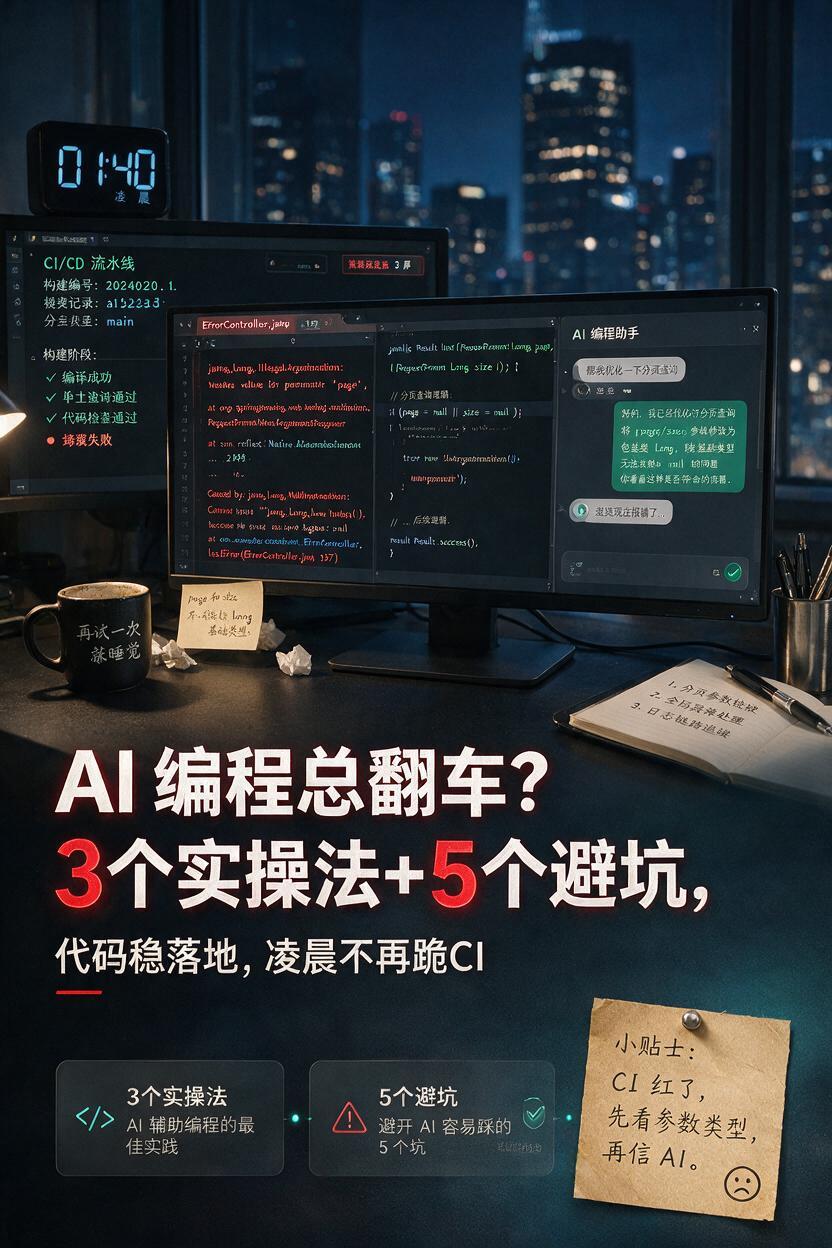
凌晨 2 点,你在多伦多家里,笔记本风扇像小飞机。美国同事的 Slack 刚活跃,PR 里躺着 7 个未读。你打开 Cursor,输入“帮我加一个支付回调接口”,它 10 秒生成 120 行代码。你眼睛一亮,合上电脑前点了提交。第二天 staging 挂了:Redis key 没设过期,事务里发 MQ,回滚后消息已经出去。
这不是段子,是很多海外码农的日常:身体被时差和 on-call 掏空,代码被 AI 的自信掏空。你缺的不是再熬两小时,而是一套能让 AI 真正落地的工程习惯。
大家对 AI 编程常有两个误区:
- 把 AI 当许愿池,觉得一句话就能交付生产代码。
- 把 AI 当自动驾驶,生成完不 review、不跑测试、不看 diff 直接 merge。
下面这些方法,来自后端项目里反复踩坑后的总结。目标只有一个:让 Cursor 帮你省时间,而不是帮你埋雷。
一、高效实战技巧:3 个能直接照搬的方法
技巧 1:先喂工程规则,再让 AI 写码
AI 幻觉最大的来源,是它不知道你的项目长什么样。你不告诉它技术栈、目录习惯、禁用依赖,它就会按训练数据里的“平均项目”猜。
操作步骤:
- 在项目根目录建
.cursorrules,写清楚:- 技术栈:Spring Boot 3、MyBatis-Plus、PostgreSQL、Redis。
- 禁止项:不要引入 QueryDSL、不要改全局异常处理、不要升级依赖。
- 测试命令:
mvn test -Dtest=xxx。 - 提交规范:一次只改一个模块。
- 新需求先别让它写代码。用
@Codebase提问:
“这个需求会碰到哪些文件?按依赖顺序列出来,并说明每个文件改动原因。先不要写代码。” - 你确认文件清单后,再让它只改第 1 个文件,输出 diff。
- 跑编译和测试,